Construye un modelo que puedas defender, sin código y sin maquillaje.
Traes una tabla en CSV o Excel, eliges qué quieres predecir y Probeta hace competir una liga de modelos dentro de tu navegador. Después te dice de frente si el ganador le gana a una regla simple, por cuánto y por qué. Si prefieres ir paso a paso, Protocolo DS te lleva por diez etapas con compuertas hasta una ficha del modelo que se escribe sola. Sin código y sin subir tus datos.
2.1 · El veredicto honesto2.1 · El veredicto honesto2.1 · El veredicto honesto
Eliges la columna y la app reconoce la tarea: aquí, sí o noLa liga entrena en tu navegador, modelo por modelo, a la vistaEl veredicto: el ganador supera a la línea base, con la cifra
Funcionalidades: Contadas contra docs/MANUAL-DE-USO.md (58 de Probeta y 19 de Protocolo DS); el pie de docs/BROCHURE.html declara el mismo número (export de la app en 988489c, 2026-10-28). Las 37 de la VISION están construidas y ninguna está descartada: nada se descarta sin una decisión escrita del usuario.Etapas del Protocolo: Las diez etapas con compuerta de Protocolo DS, construidas (src/engine/protocolo/etapa1.ts a etapa10.ts); cada una con su criterio de salida verificado por código. Lo recuenta tests/unit/brochure-export.test.ts.Filas de datos del usuario que salen del navegador: Veinticuatro specs e2e vigilan las peticiones de red (contadas el 2026-10-28 sobre 988489c: las de Probeta, también la pregunta a tus datos, y las de las etapas 4 a 10 del Protocolo): fallan si una lleva valores del dataset o, sin consentimiento, una petición de narración. Lo único que sale con contenido del usuario es la narración con IA, a petición y solo con agregados: 652 B medidos.Pruebas unitarias y de integración: Salida del 2026-10-28 sobre el árbol final del S21 (988489c): `pnpm test` 3114 pruebas en 174 archivos + `pnpm test:integration` 347 en 25 archivos (con Pyodide real; 10 más se saltan a propósito: las mediciones con `MEDIR=1` y el emisor del fixture del S6). Aparte, 23 pruebas de Python en CPython 3.14.0 que corre el job `integration` (el servicio, la receta y el SQL).Cobertura de líneas: v8 sobre engine, lib, components y workers; 12169 de 12762 líneas (salida de `pnpm test` del 2026-10-28 sobre 988489c: imprime 95,35 %). Los motores puros de engine/ llevan umbral propio más alto.
75 pantallas reales · datos sintéticos
1Del mapa al capítuloToca una caja del mapa y se abre su capítulo; «Volver al mapa» te regresa a esa caja, y «↩ Volver» a donde estabas.
2Cajas y flechasCada capítulo trae su flujo. Una caja con el ícono de pantalla la muestra: pásale el cursor o tócala.
3Fichas que se volteanConcepto, diferencia y decisión. Toca una ficha para ver la respuesta.
4El Recorrido de la AppTodas las pantallas, a pantalla completa. Pasa con ← y → del teclado.
01
01 · Lo que cambia
Para quién y por qué
Para quién
Para analistas, financieros, ingenieros e investigadores aplicados que saben pensar con datos pero no son científicos de datos, y que tienen que defender un modelo ante su jefe o su comité, no ganar una competencia de puntajes.
Lo que la hace distinta
Entrenar un modelo ya no es lo difícil; lo difícil es saber si se le puede creer. Probeta te muestra la pantalla en la que tu modelo pierde: si no le gana a una regla simple de referencia, dice «NO supera», con la cifra. La prueba nunca contamina el entrenamiento: la preparación de los datos, como rellenar vacíos, aprende solo de la parte de entrenamiento, y la interfaz no ofrece otro camino. El ganador se elige con validación cruzada, sin mirar la prueba, y la prueba se usa después, para el veredicto. Y si una columna adivina el resultado casi a la perfección, el titular dice «sospechoso» en vez de celebrar. En Protocolo DS la honestidad además detiene: ninguna etapa abre sin cumplir la anterior, la prueba queda sellada antes de entrenar y se abre una sola vez, y «no usarlo» es un resultado válido que queda escrito.
02
02 · El mapa
1El mapa
02 · Los capítulos del mapa
Un capítulo por grupo: qué resuelve, cuándo te sirve, cómo funciona, sus pantallas y sus fichas.
2.1
2.1 · El veredicto honesto★ La estrellaUna liga de modelos entrena con tu tabla y te dice, con la cifra exacta, si el ganador sirve o no. · 14 funcionalidades
AbrirCerrar
Qué resuelve
Una liga de modelos entrena con tu tabla y te dice, con la cifra exacta, si el ganador sirve o no.
Sus piezas 14
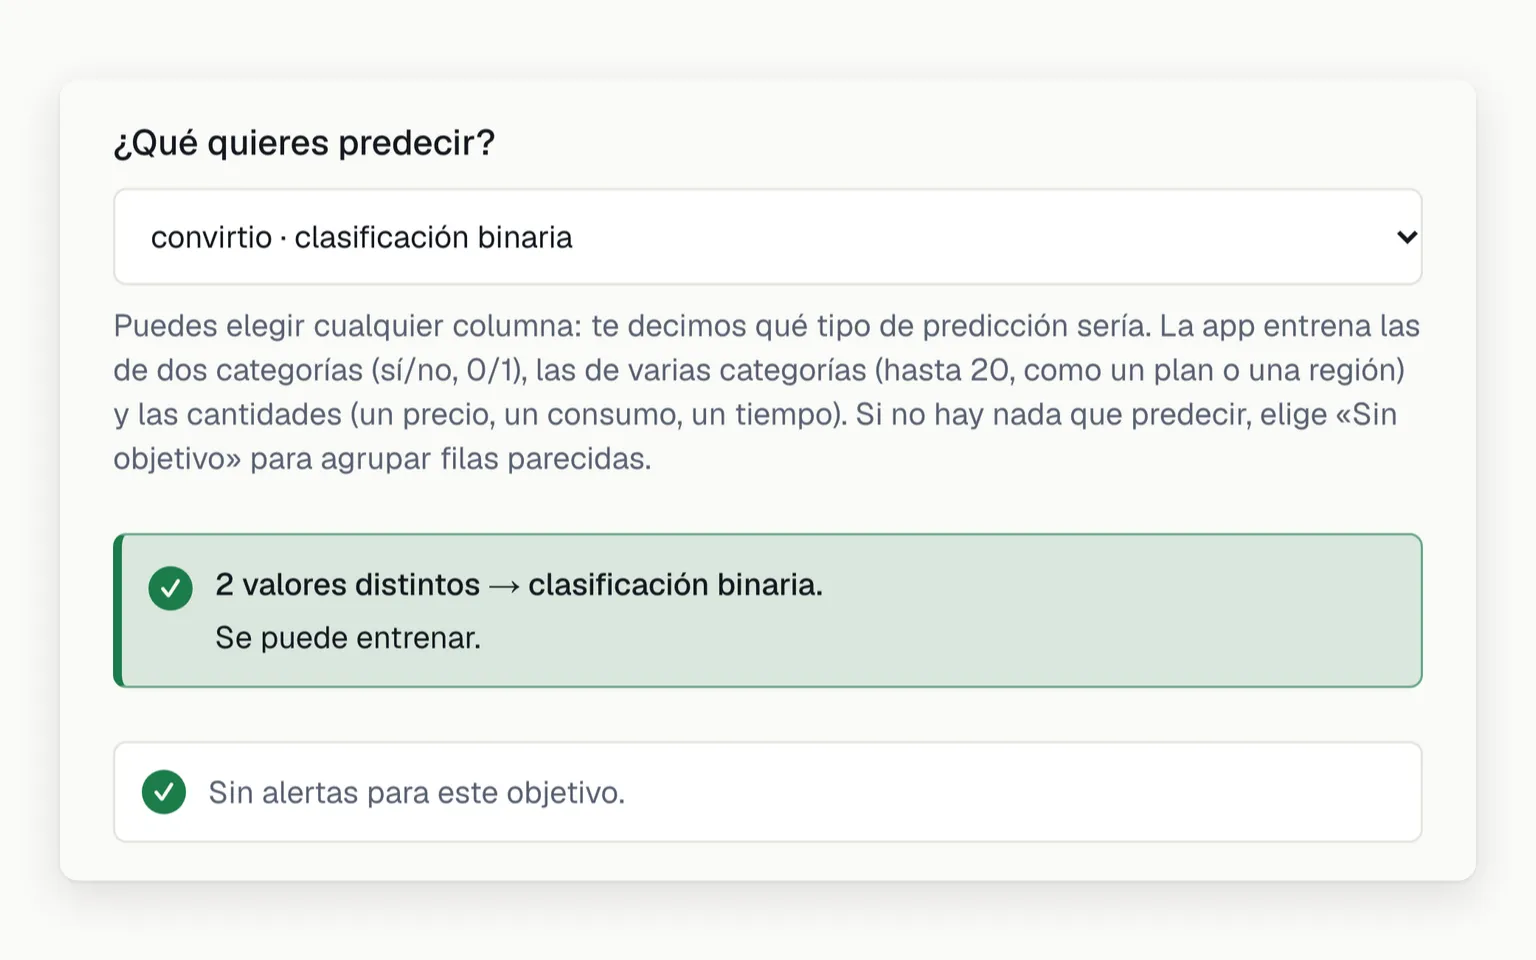
V1Tú eliges qué predecir
Respondes una sola pregunta, qué columna quieres predecir, y la app reconoce la tarea por ti. Puede ser un sí o no, de 3 a 20 categorías o una cantidad, como un precio. Si no hay nada que predecir, te ofrece agrupar filas parecidas.
Eliges la columna y la app reconoce la tarea: aquí, sí o no
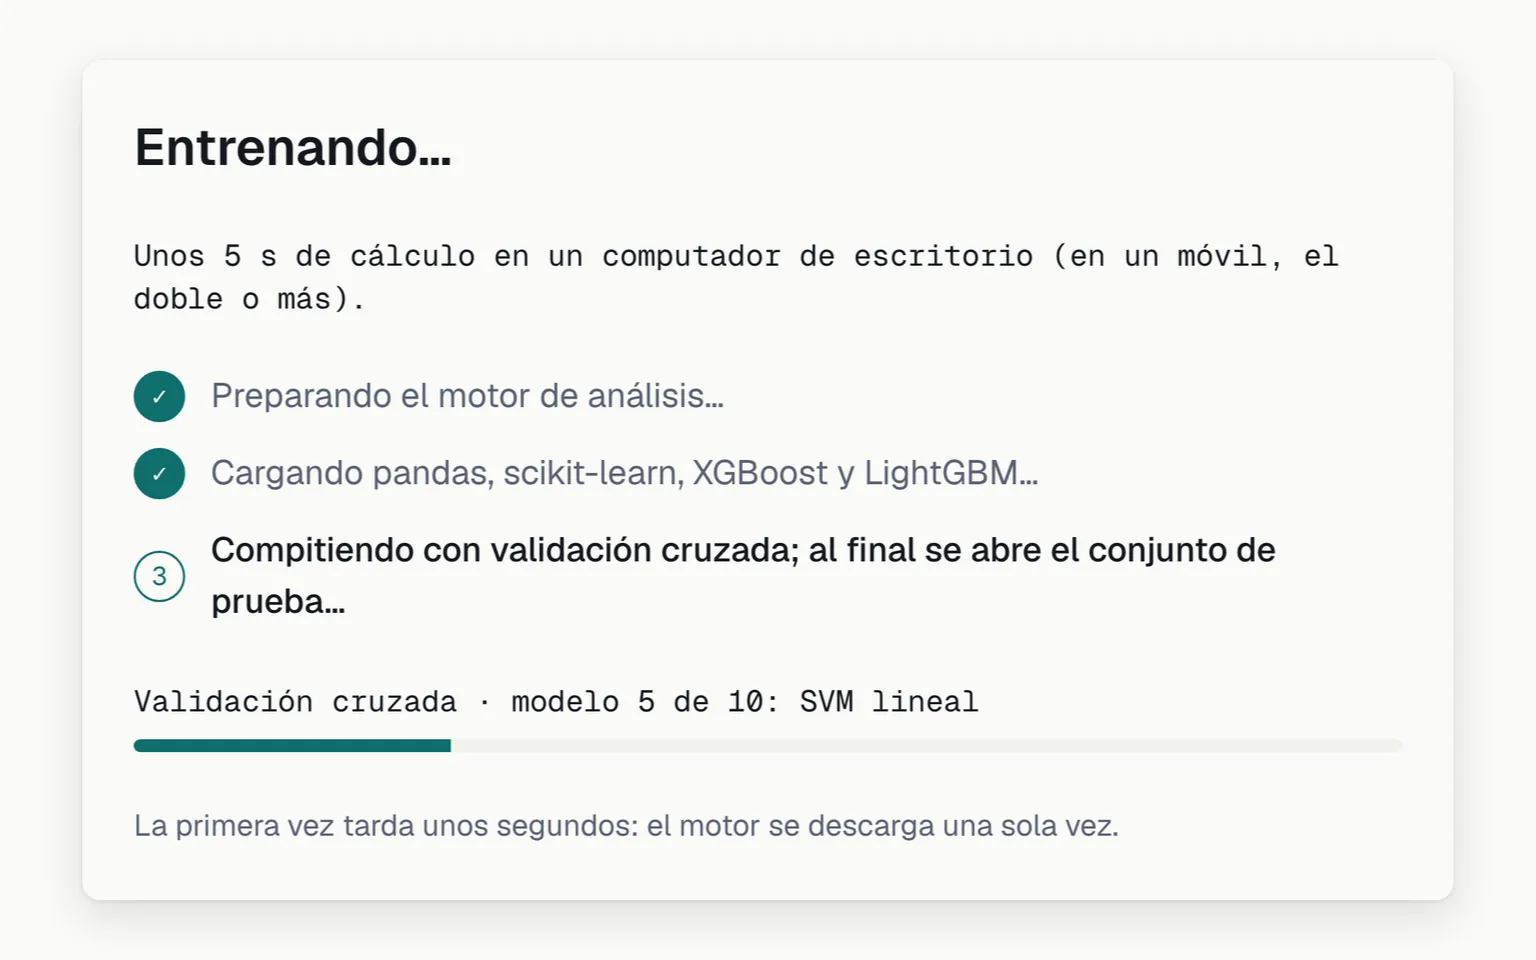
V2El entrenamiento, con el progreso a la vista
Ves en todo momento qué modelo está compitiendo y cuánto falta, con una barra de avance y el tiempo estimado. Todo el cálculo corre dentro de tu navegador, sin pantallas en blanco.
La liga entrena en tu navegador, modelo por modelo, a la vista
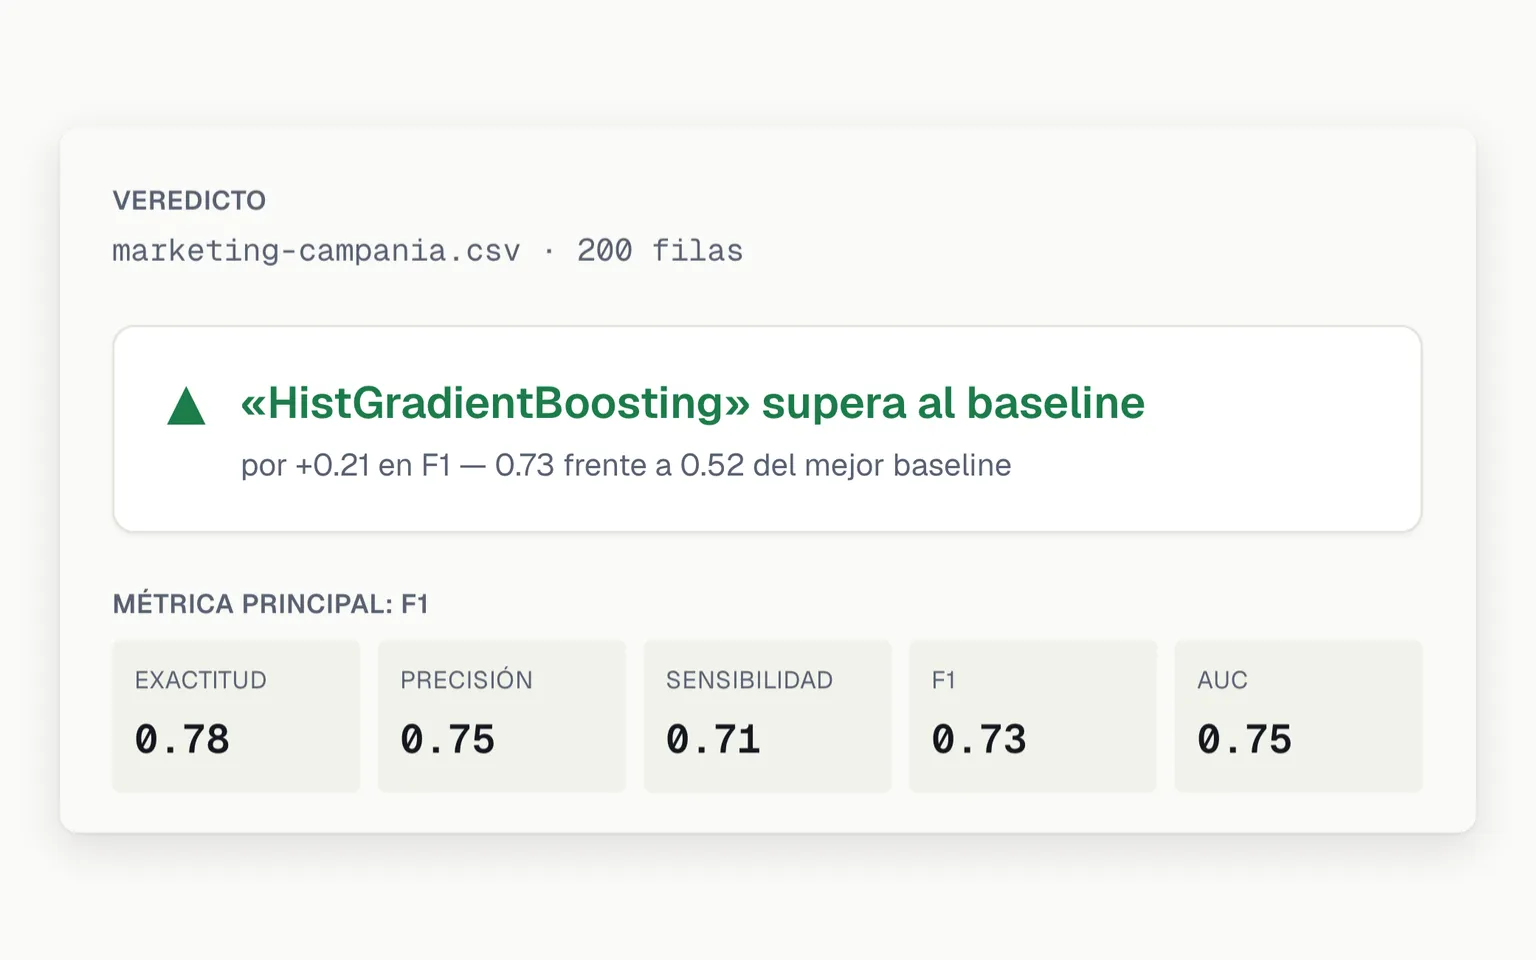
V3El veredicto: ¿le gana a lo simple?
Sabes de un vistazo si tu modelo vale la pena: ▲ supera, = empata o ▼ NO supera a la línea base, una regla simple de referencia, con la diferencia exacta. Si el modelo no aporta, la app lo dice de frente.
El veredicto: el ganador supera a la línea base, con la cifra
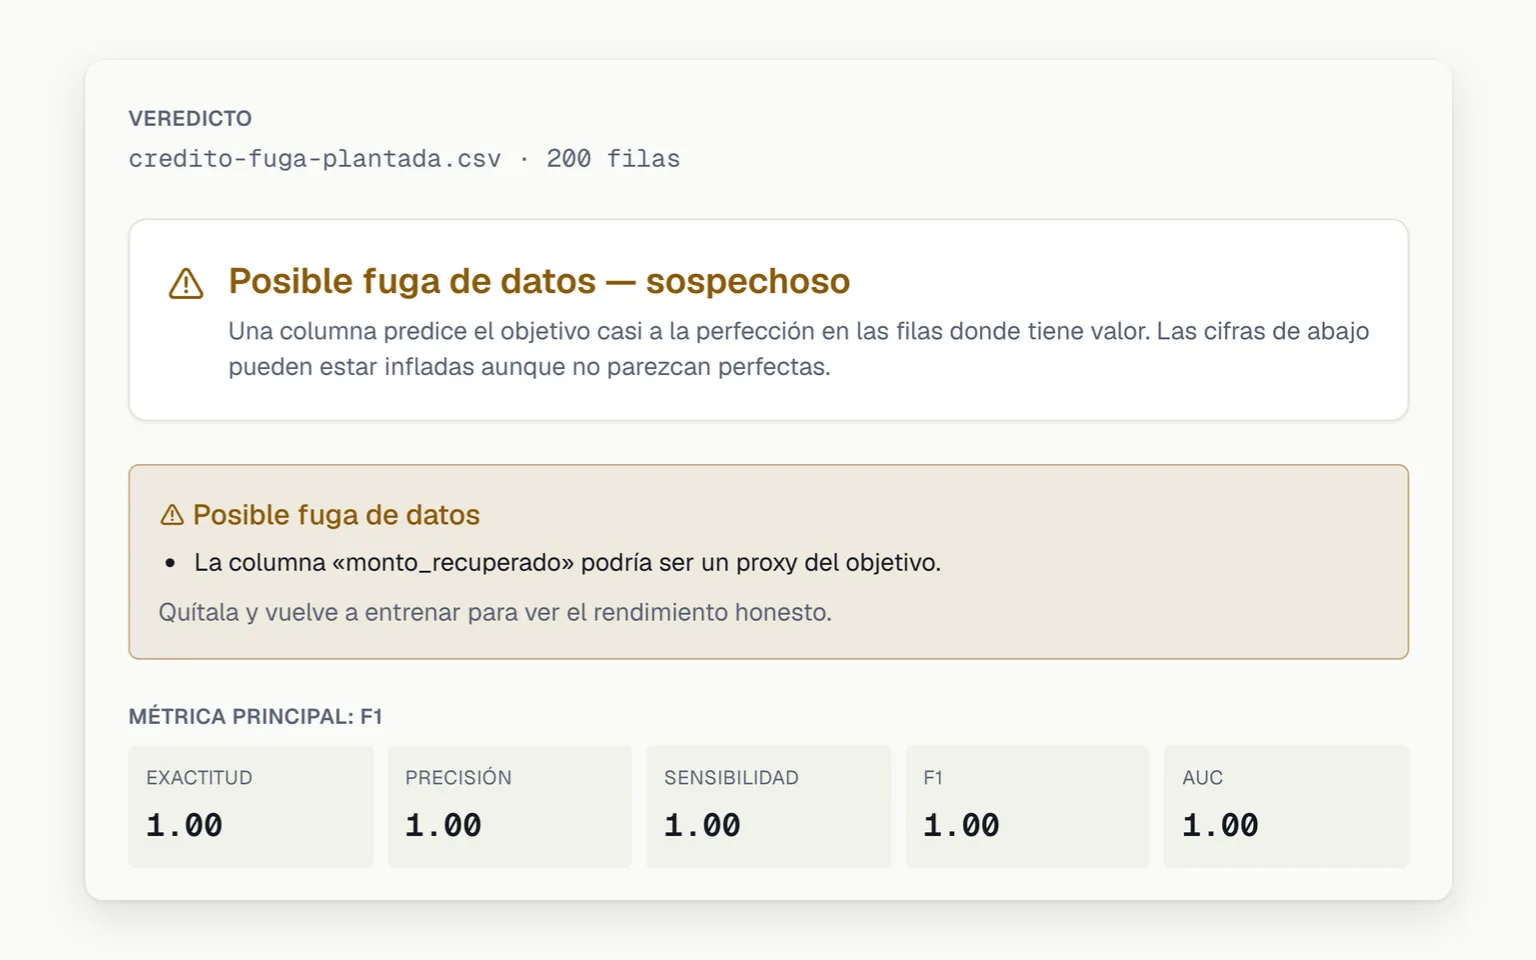
V4Un resultado demasiado bueno no se celebra
Te protege del espejismo más caro: si una columna predice el resultado casi a la perfección, el titular dice «Posible fuga de datos: sospechoso» en vez de «supera». Casi siempre es un dato que no tendrías al momento de predecir.
Una columna adivina demasiado bien: el titular dice «sospechoso»
V5La columna sospechosa, con nombre propio
Sabes exactamente qué columna revisar: la app nombra la que podría estar delatando el resultado y te dice qué hacer, quitarla y volver a entrenar. Con varias categorías, nombra también la categoría que esa columna delata.
Antes de entrenar, la alerta nombra la columna que delata el resultado
V6Métricas medidas sobre datos no vistos
Cada cifra se calcula sobre la cuarta parte de tus filas que el modelo nunca vio al entrenar. Con dos categorías ves exactitud, precisión, sensibilidad, F1 y AUC; con varias, la exactitud balanceada; al estimar, el error en las unidades de tu columna.
Al estimar, el error se lee en kWh, sobre datos no vistos
V7Matriz de confusión: en qué se equivoca
Ves no solo cuánto acierta el modelo, sino en qué se equivoca. Una tabla cruza lo real con lo predicho y muestra cuántos casos confundió en cada dirección, para que sepas qué error comete más.
La matriz de confusión: aciertos y errores, sobre la prueba
V8Los rivales simples, a la vista
Ves contra quién compite tu modelo y con qué cifras: al clasificar, responder siempre lo más frecuente y una regresión logística; al estimar, la mediana y una regresión lineal. Ganarle al mejor de ellos es la condición para servir.
Aquí ningún modelo le gana a la regresión de referencia, y lo dice
V9Una liga de modelos, elegida sin mirar la prueba
Obtienes al mejor de hasta 14 modelos sin inflar el resultado: compiten con validación cruzada, que los mide rotando partes del entrenamiento, y la prueba se reserva para el veredicto. Si prefieres otro, lo eliges y queda marcado «elegido por ti».
La liga: once modelos con validación cruzada, sin mirar la prueba
V11Estimar una cantidad, con el error en sus unidades
Si quieres predecir un número, como un precio o un consumo, compiten 11 modelos y el veredicto dice cuánto se equivoca en promedio, en las unidades de tu columna. Un gráfico enfrenta lo estimado con lo real.
Estimado frente a real: cada punto, una fila de la prueba
V13Clasificar en varias categorías
Si tu respuesta tiene de 3 a 20 categorías, como un plan o una región, el veredicto usa la exactitud balanceada, que pesa igual cada categoría. La matriz marca los aciertos con ✓ y una frase nombra la confusión más frecuente.
Cinco categorías: la matriz marca los aciertos con ✓
V12¿Categorías o una cantidad? Te lo pregunta
Cuando una columna tiene pocos números distintos, como una nota del 1 al 5, la app no adivina si son categorías o una cantidad: te pregunta, con la lectura más probable marcada. Las dos respuestas entrenan.
¿Categorías o una cantidad? La app pregunta en vez de adivinar
V10Nuevo experimento con un clic
Vuelves al inicio con un solo botón para probar otra tabla u otra pregunta, sin recargar la página. El siguiente experimento arranca desde cero.
Un botón para empezar otro experimento desde cero, aquí con el foco
V14El margen de error de la cifra
Sabes cuánto podría moverse la cifra del veredicto con otra muestra de las mismas filas: la app remuestrea mil veces la prueba y te da un intervalo del 95 %. Con la misma semilla, repetirlo da lo mismo.
El margen de error: un intervalo del 95 % para la cifra
2.2
2.2 · Datos reales, tratados de frenteCSV o Excel con huecos, basura y filas repetidas: se limpian a la vista y cada paso te lo cuentan. · 12 funcionalidades
AbrirCerrar
Qué resuelve
CSV o Excel con huecos, basura y filas repetidas: se limpian a la vista y cada paso te lo cuentan.
Sus piezas 12
D1Sube tu tabla, sin que salga de tu equipo
Arrastras tu archivo o lo eliges con un clic, y empiezas a trabajar al instante. El archivo se lee dentro de tu navegador: tus filas no se suben a ningún servidor.
Arrastras tu archivo y se lee en tu navegador, sin subirlo
D2Siete ejemplos para probar sin datos propios
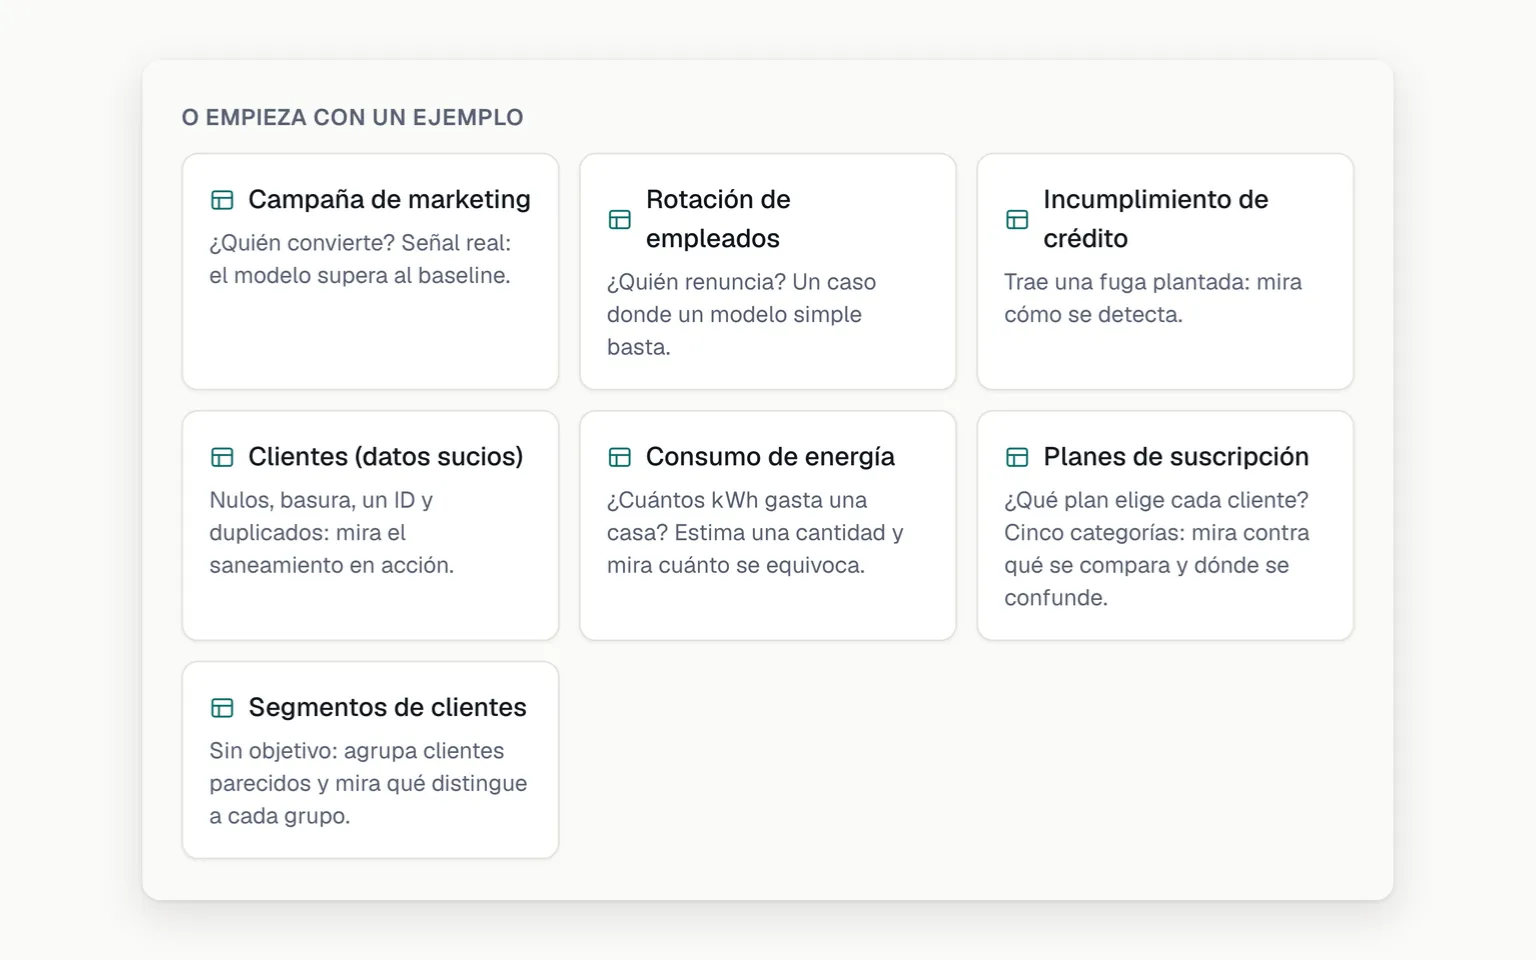
Recorres la app entera sin traer nada tuyo: siete tablas sintéticas, de una campaña de marketing al consumo de energía de una casa, cada una pensada para mostrar algo, como una fuga plantada o datos sucios.
Siete ejemplos sintéticos para recorrer la app sin datos propios
D3Vista previa con el perfil de cada columna
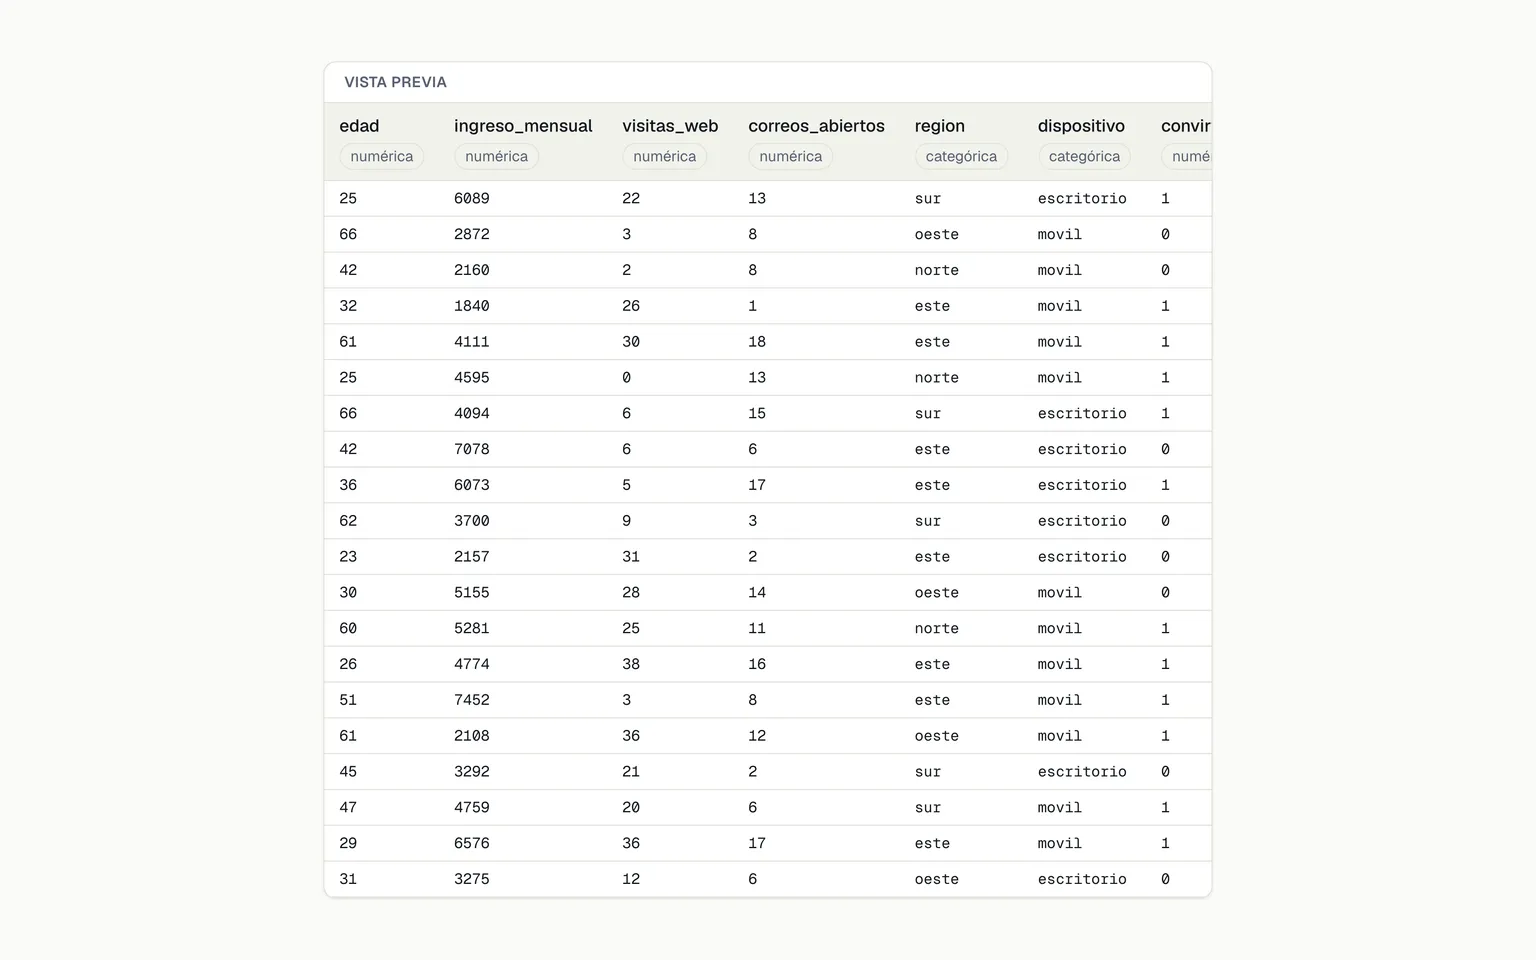
Antes de entrenar ves tu tabla y el tipo de cada columna, numérica o de categorías, con sus valores vacíos. Si una columna parece una fecha, la app te avisa, porque las fechas no entran al entrenamiento.
La vista previa, con el tipo de cada columna
D4Límites dichos de frente
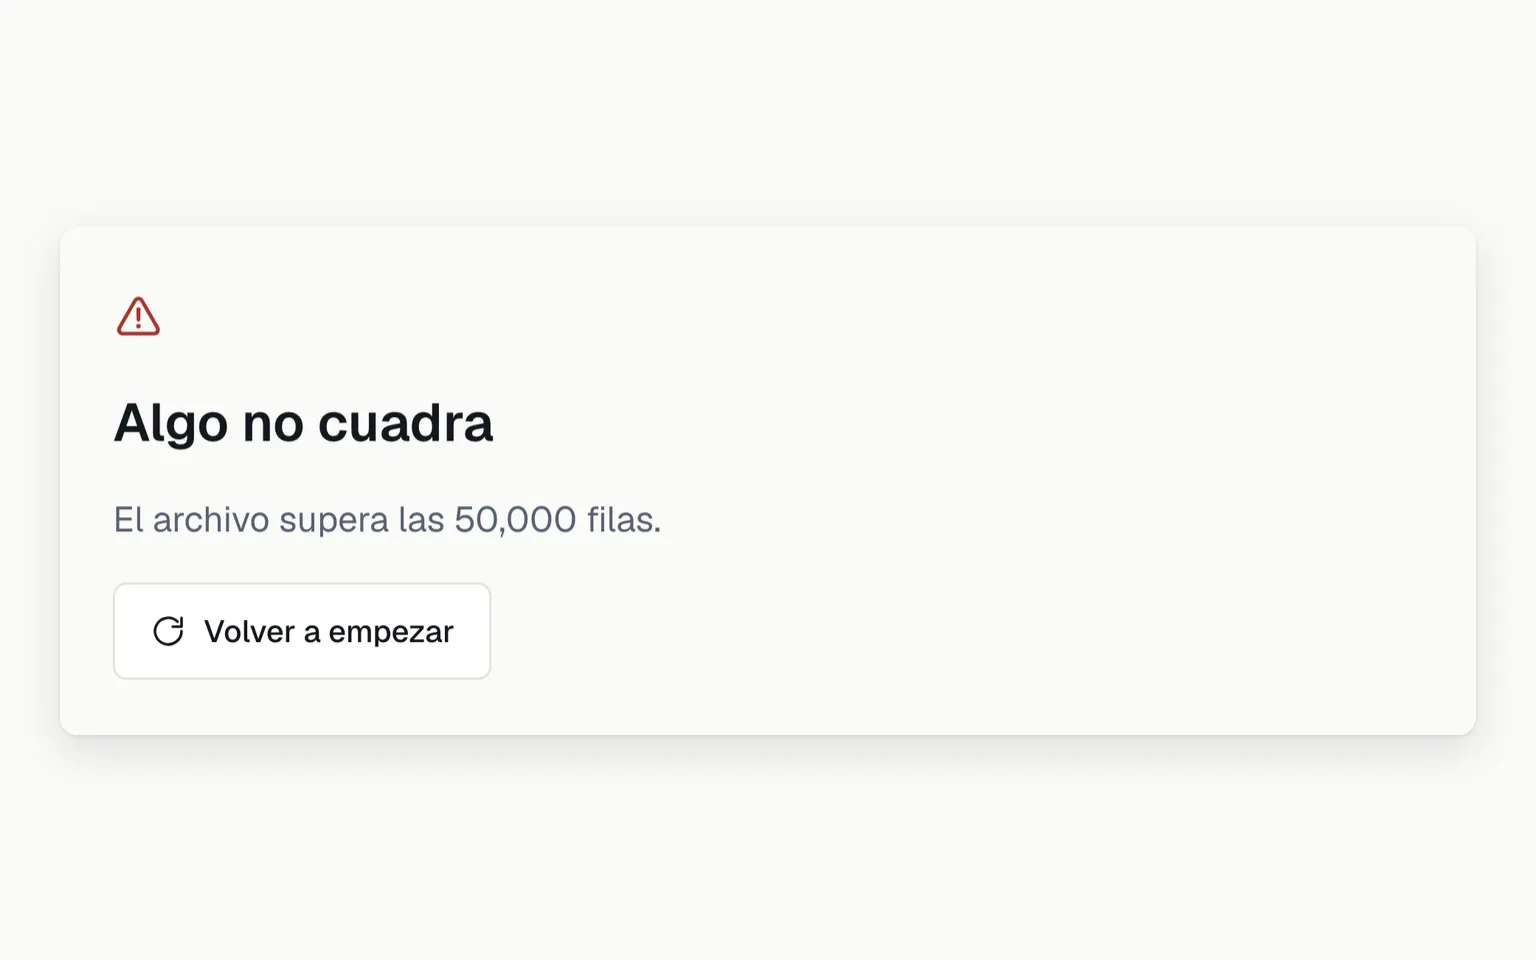
Sabes desde el inicio hasta dónde llega: archivos de hasta 5 MB o 50 000 filas. Si el tuyo es más grande, la app te avisa en lugar de colgarse fingiendo que trabaja.
Un archivo de más de 50 000 filas: la app lo dice en vez de colgarse
D5Limpieza automática, con el conteo exacto
Tu tabla llega limpia y sabes qué se le hizo: se quitan filas duplicadas, se apartan columnas que identifican o no cambian y se vacían celdas basura, cada cosa con su conteo. Si venía limpia, te dice «nada que sanear».
La limpieza, contada: duplicados, columnas apartadas y celdas basura
D6Cinco alertas antes de entrenar
Te enteras de los riesgos antes de entrenar: una columna que huele a fuga, otra que parece un identificador, un resultado desbalanceado y, al estimar, un objetivo muy sesgado o con valores extremos. Cada alerta lleva símbolo y texto, nunca solo color.
Antes de entrenar: una posible fuga y un objetivo sesgado, con símbolo
D7El CSV de Excel en español, detectado
Si tu CSV viene separado con punto y coma, como lo guarda Excel en español, la app te dice cuál es el separador y cómo volver a guardarlo. No lo adivina, porque una mala lectura convertiría tus columnas de números en categorías sin avisarte.
Un CSV con punto y coma: la app nombra el separador real
D8También entra un Excel
Traes tu libro de Excel tal cual y la app lo lee en tu navegador, con los mismos límites que un CSV, y te dice qué hoja leyó. Uno con contraseña, uno antiguo (.xls) o uno dañado se rechaza explicando por qué.
Entra un Excel: la app dice qué hoja leyó
D9Aviso de posibles datos personales
Te enteras de si tu tabla trae datos personales, como correos, teléfonos, documentos o nombres: la app te dice la columna, el tipo y, si lo vio en las celdas, qué parte tiene esa forma, nunca un valor. Es un aviso aproximado, no un bloqueo.
Aviso de datos personales: columna, tipo y qué parte de las celdas, sin valores
D10Un plan de limpieza que apruebas tú
Recibes hasta doce pasos de limpieza, cada uno con lo que hace, cuántas celdas toca y cómo se deshace. Tú apruebas o rechazas cada paso: lo que no apruebas no se aplica, y tu decisión queda en la ficha y en el archivo del modelo.
El plan de limpieza: apruebas o rechazas cada paso
D11Explora tus datos antes de entrenar
Entiendes tu tabla antes de modelarla: cómo se reparte cada columna, qué números se mueven juntos y qué categorías van de la mano, con un resumen escrito. Cada cifra del resumen se recalcula aparte desde tu tabla antes de mostrarse.
Explora tus datos: un resumen verificado contra tus números
D12Pregúntale a tus datos con tus palabras
Obtienes respuestas de tu tabla escribiendo la pregunta, como «ventas del último trimestre por región»: tabla, gráfico y una frase verificada. Antes de calcular ves cómo la entendió y qué comprobó, y lo dudoso te lo pregunta. Sin IA: tu pregunta no sale del navegador.
Escribes la pregunta y, antes de correr, ves cómo la entendió y qué comprobó
2.3
2.3 · El porqué, contado honestoQué columnas pesan, hacia dónde empujan, cuánto aguanta el modelo y una explicación en palabras llanas. · 7 funcionalidades
AbrirCerrar
Qué resuelve
Qué columnas pesan, hacia dónde empujan, cuánto aguanta el modelo y una explicación en palabras llanas.
Sus piezas 7
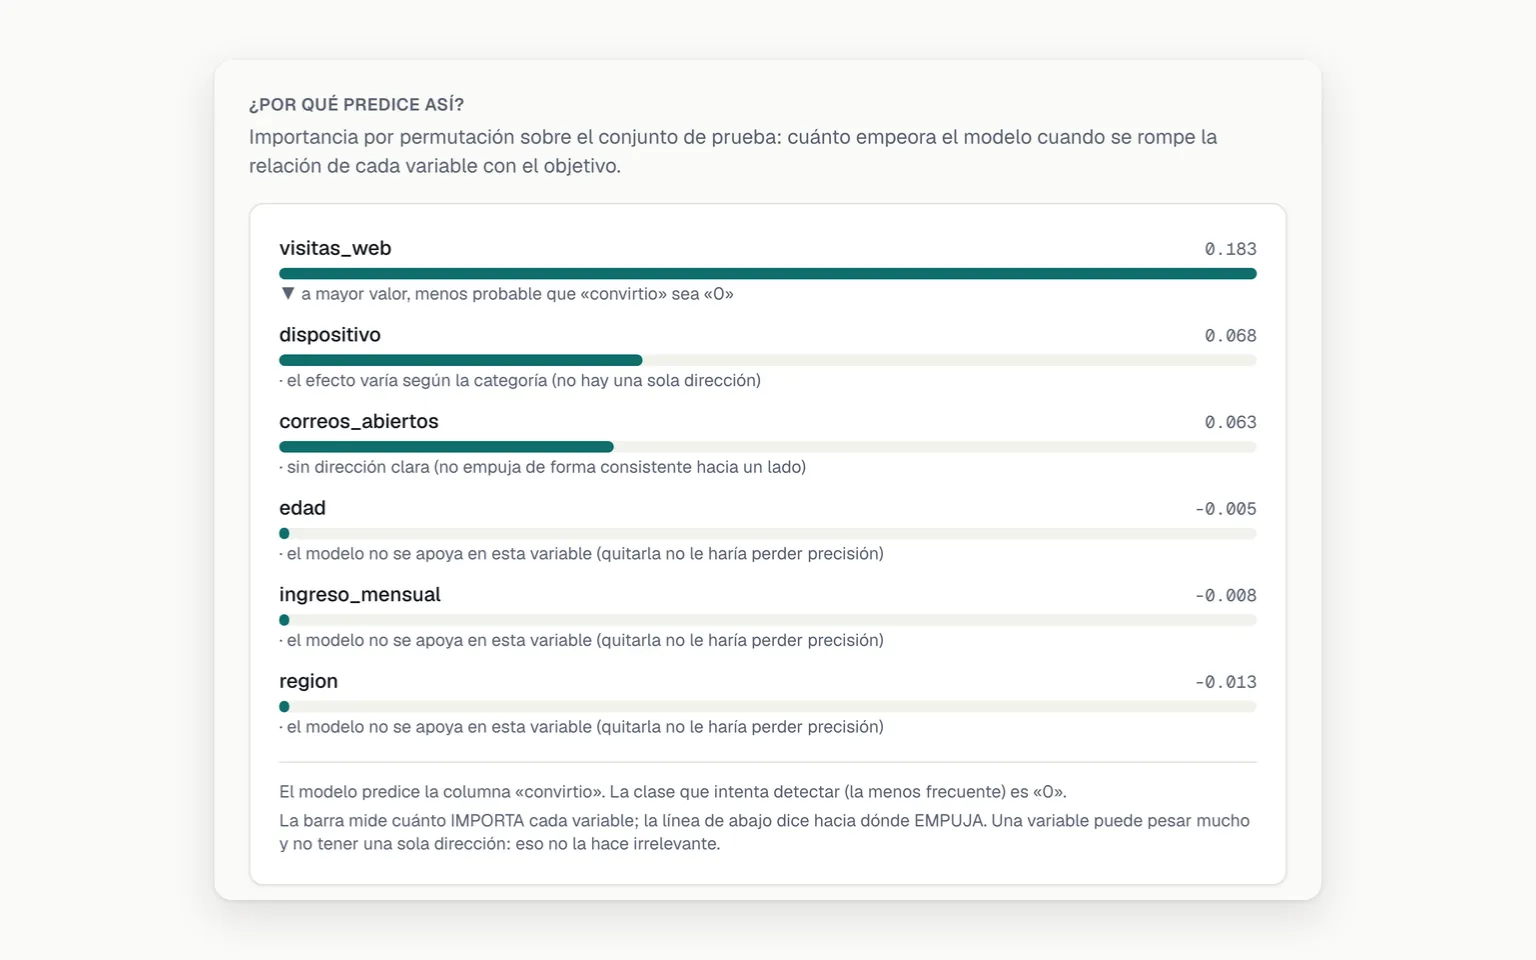
P1Qué pesa en el modelo, y hacia dónde
Ves qué columnas pesan más en las predicciones y hacia dónde empujan, medido al desordenar cada una sobre la prueba. Si el modelo no se apoya en una columna, no se le pinta una flecha que la medición no respalda.
Qué columnas pesan y hacia dónde empujan, medido en la prueba
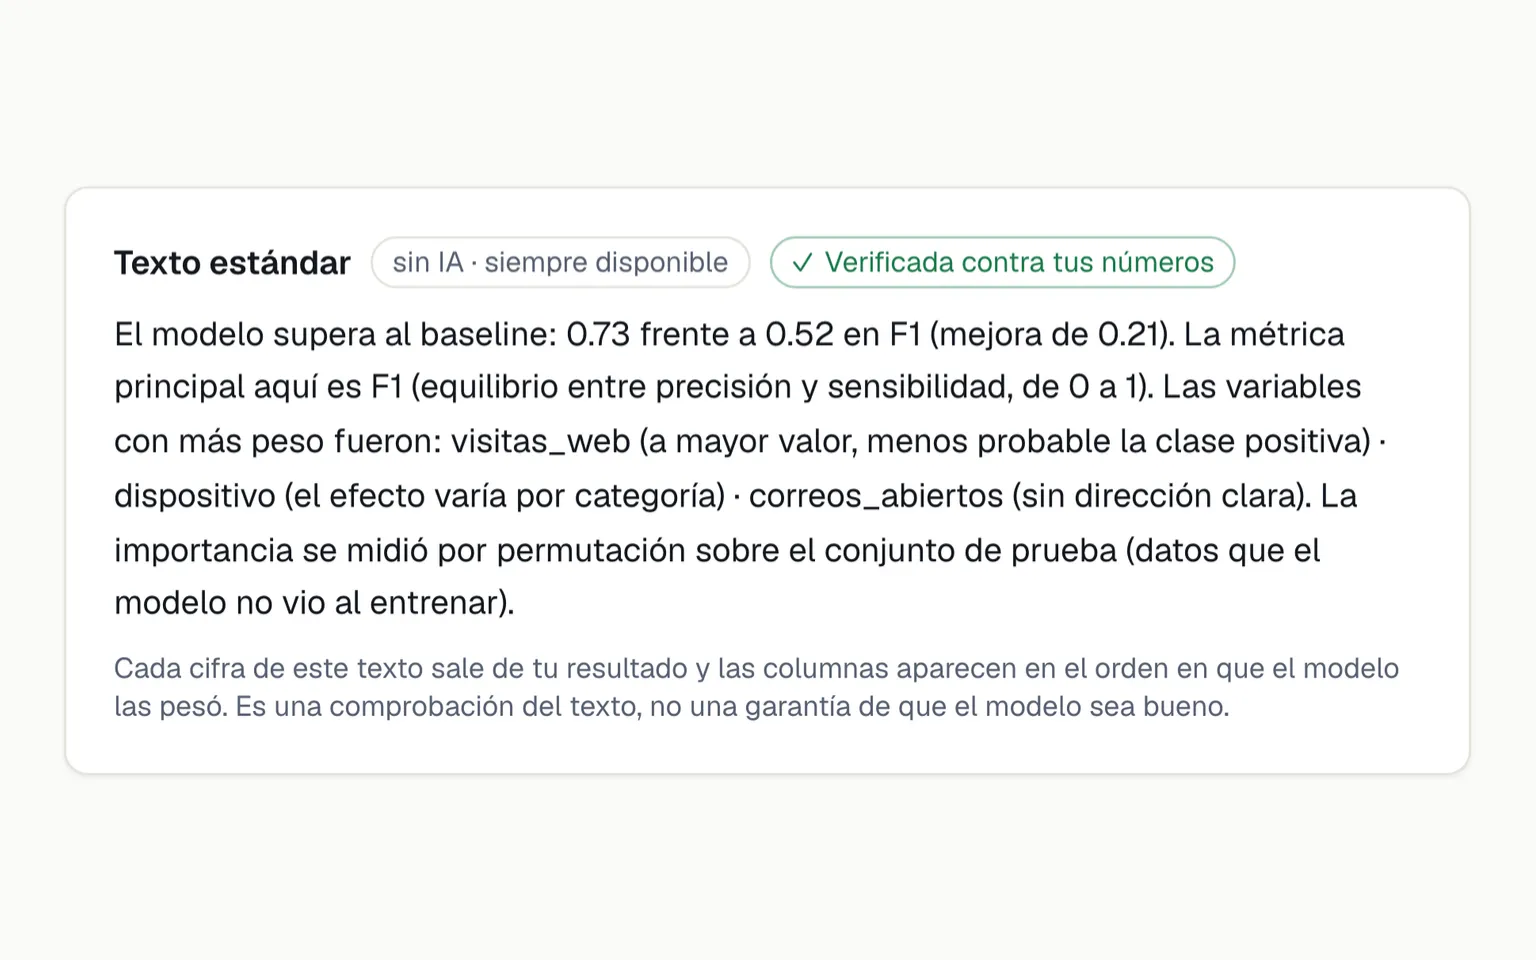
P2Una explicación en palabras llanas, sin IA
Lees en palabras llanas el veredicto, qué mide la métrica principal y qué columnas pesan más. La escribe la propia app con los números de tu experimento, sin IA ni internet, así que siempre está ahí.
La explicación de la app, sin IA, verificada contra tus números
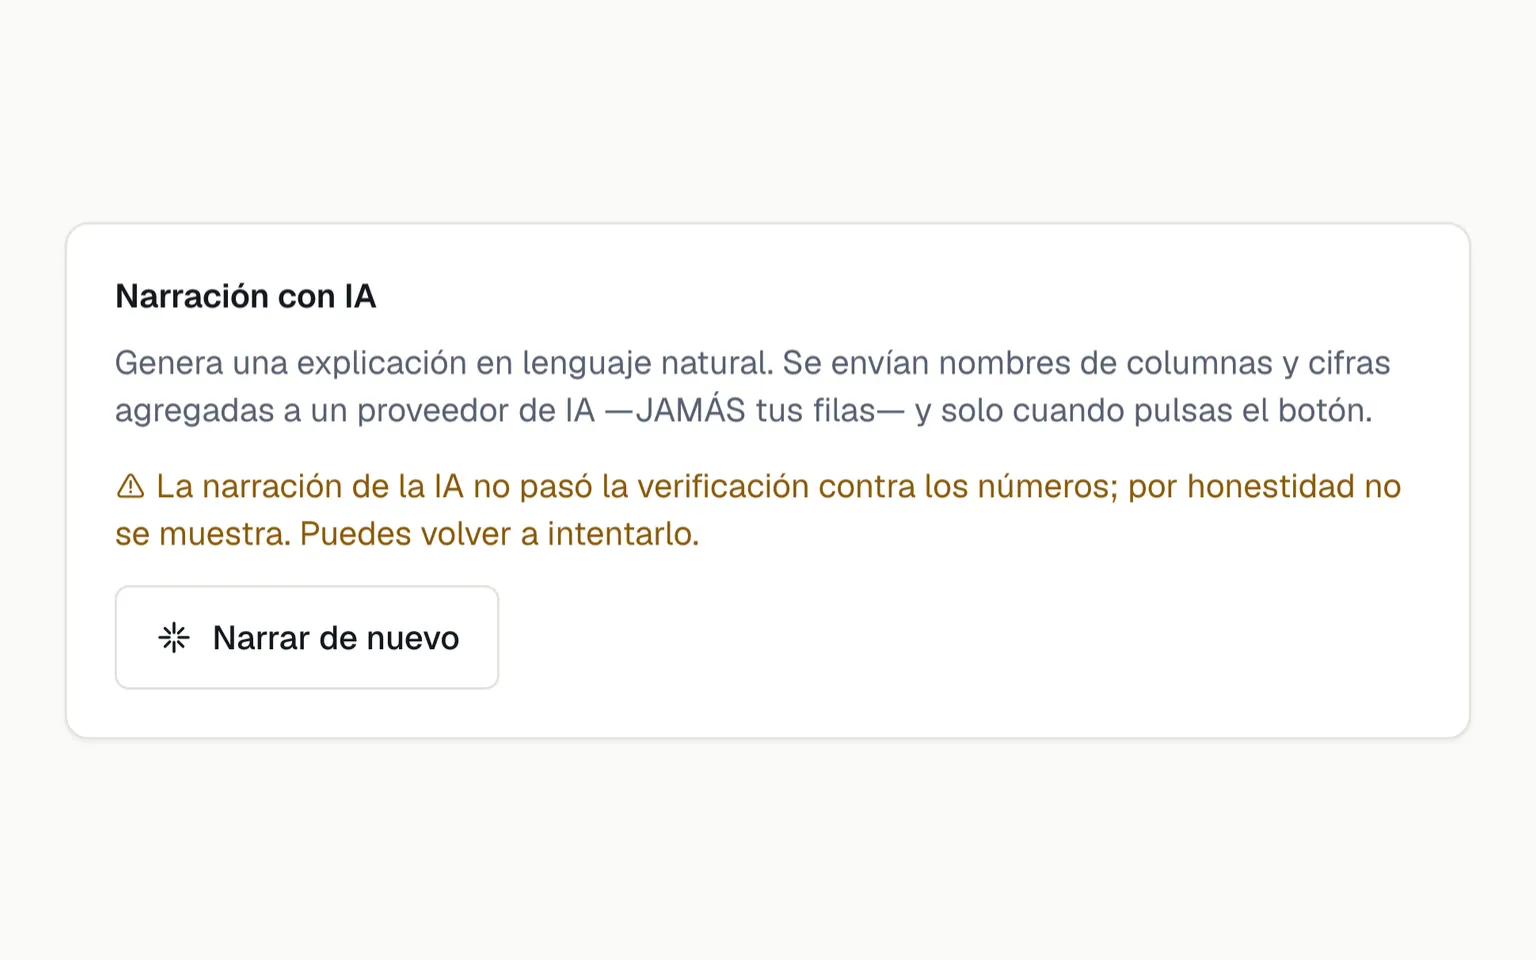
P3Narración con IA, solo si la pides
Si quieres una narración más natural, la pides con un botón y llega marcada «✓ verificada con los números». Si la IA cita una cifra o una columna que no existe, se descarta antes de mostrarse. Hoy cubre las tareas de dos categorías.
Si la narración de la IA no cuadra con tus números, no se muestra y lo dice
P4Si la narración falla, sabes por qué
Si la narración con IA no llega, la app te dice el motivo: el proveedor no respondió, no pasó la verificación o no está configurada. Un botón te deja intentarlo de nuevo, y la explicación de la app sigue ahí.
Si la narración falla, dice por qué y deja reintentar
P5La ficha del experimento, descargable
Te llevas en un documento la constancia completa de tu experimento, su ficha o «model card»: los datos, cómo se partieron, el método, las métricas, el veredicto y sus límites. Se arma en tu navegador, en tu idioma.
La ficha del experimento, lista para descargar
P6Prueba de estrés: ¿cuánto aguanta?
Sabes cuánto de tu veredicto sobrevive si los datos cambian: el mismo modelo se mide con ruido, con una columna revuelta y con un corrimiento como el del paso del tiempo. Al final dice si todavía le gana a su rival sin modelo.
Estrésalo: cuánto cae la cifra con ruido y si aún gana
P7Explicaciones comprobadas contra tus números
Cada explicación escrita pasa una comprobación antes de mostrarse: sus cifras tienen que ser las de tu resultado y las columnas, en el orden en que pesaron. Si no cuadra, ves solo las cifras. Comprueba el texto, no la calidad del modelo.
Al estimar, la explicación también pasa la comprobación
2.4
2.4 · El modelo sale a trabajarPuntúa tablas nuevas, simula decisiones, vigila su desempeño y se va contigo fuera de Probeta. · 18 funcionalidades
AbrirCerrar
Qué resuelve
Puntúa tablas nuevas, simula decisiones, vigila su desempeño y se va contigo fuera de Probeta.
Sus piezas 18
U1Puntuar datos nuevos
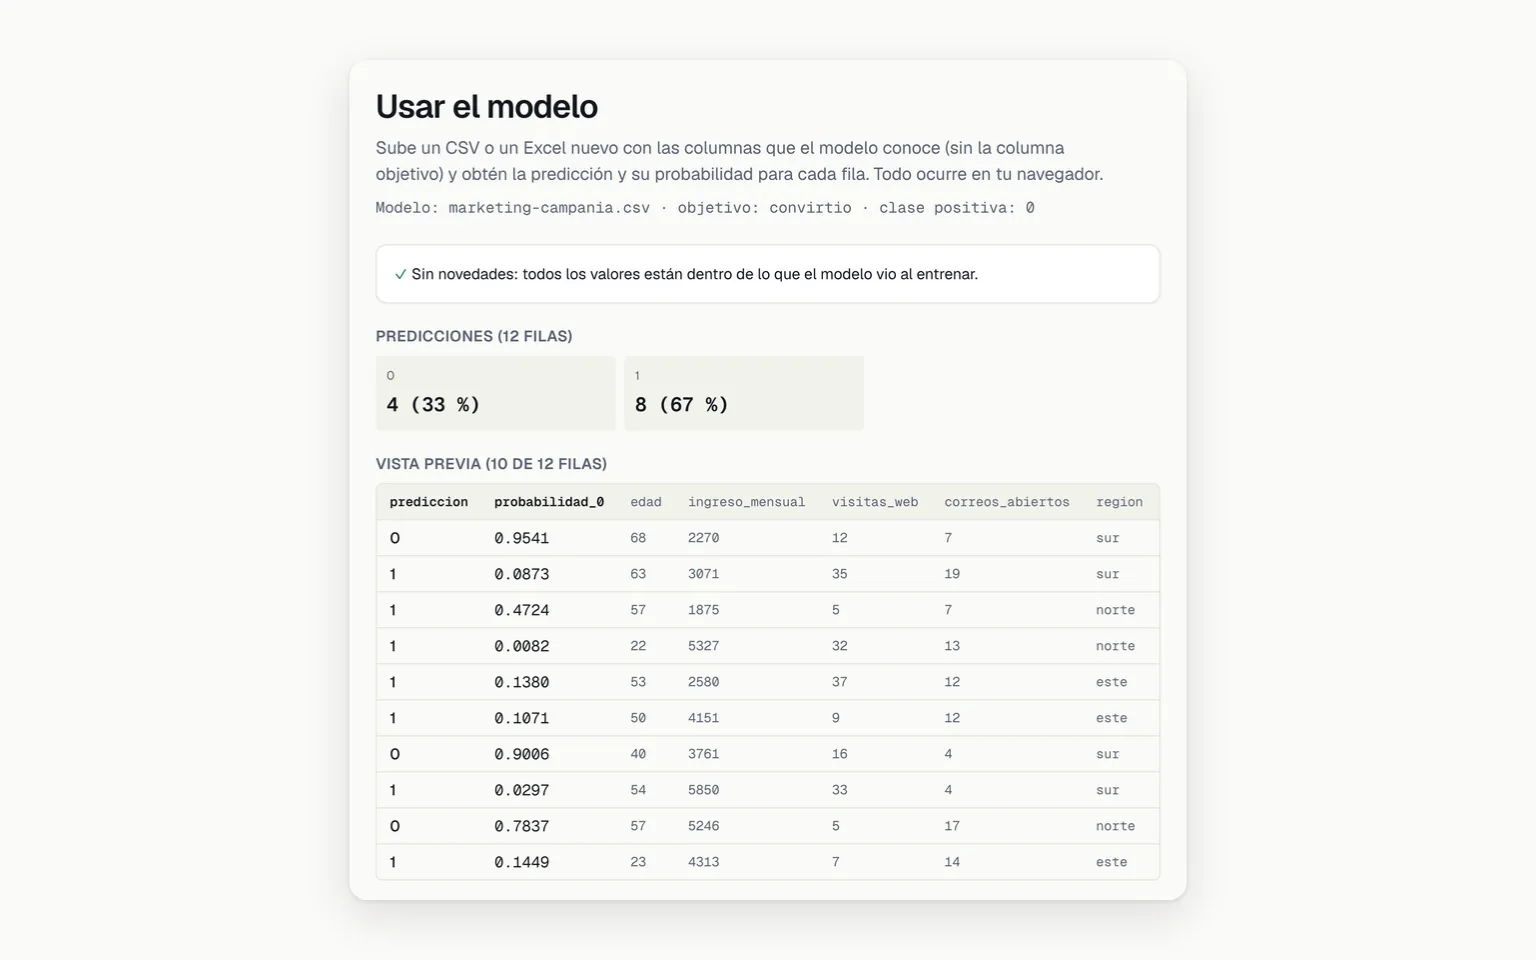
Subes otra tabla con las mismas columnas y obtienes la predicción de cada fila, sin volver a entrenar. No hace falta la columna que predices: aquí es el modelo el que responde.
Puntuar datos nuevos: cada fila sale con su predicción y su probabilidad
U2Si falta una columna, no adivina
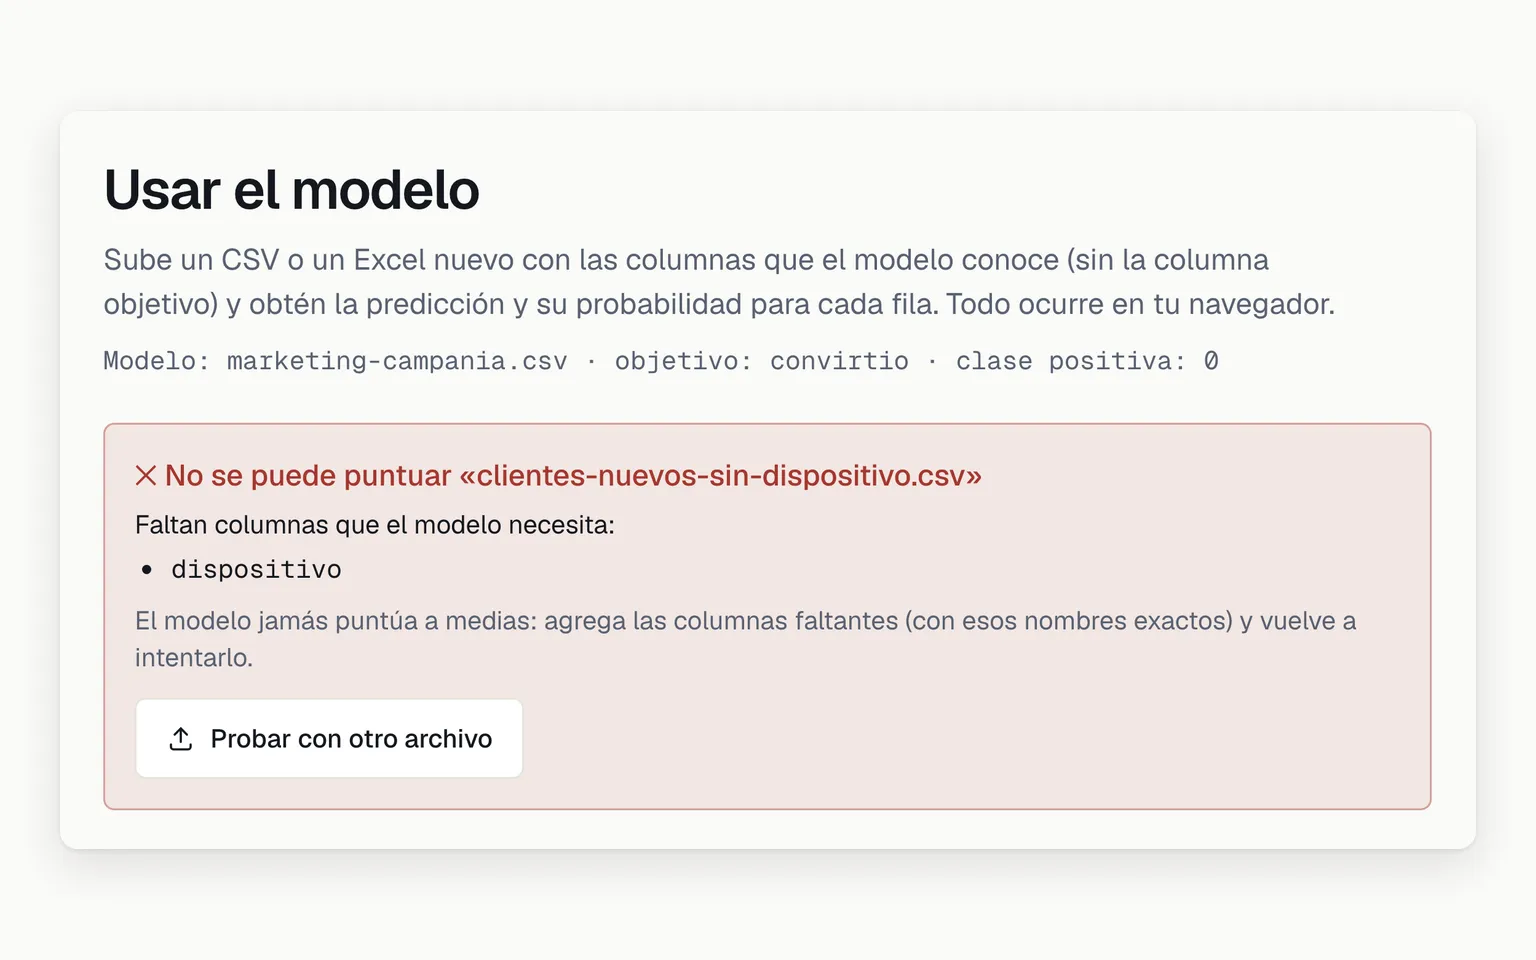
Si a tu archivo nuevo le falta alguna columna que el modelo necesita, la app se niega a puntuar y te dice exactamente cuáles faltan. Nunca rellena en silencio para darte un resultado a medias.
Falta una columna: la app se niega a puntuar y dice cuál
U3Te dice dónde el modelo está adivinando
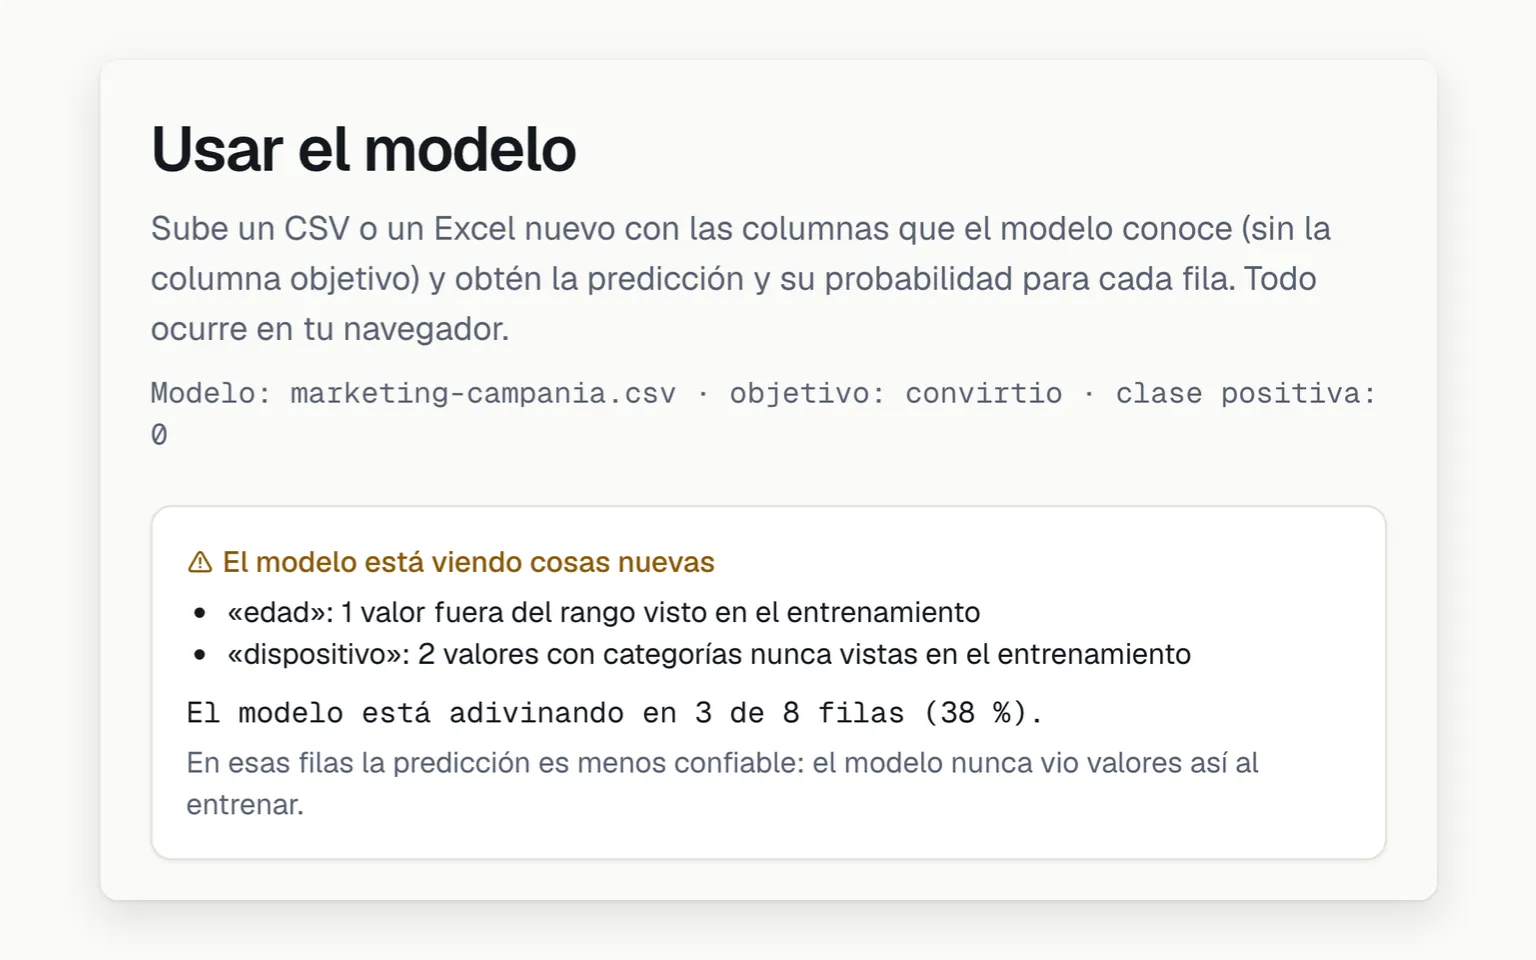
Sabes en qué parte de tus filas nuevas el modelo adivina: la app cuenta los valores que nunca vio al entrenar, como categorías nuevas o números fuera de rango, y te dice en qué porcentaje de filas aparecen.
El aviso de novedad: en cuántas filas nuevas el modelo adivina
U4Las predicciones, antes de descargarlas
Antes de descargar nada ves cómo se reparten las predicciones y una vista previa de tu tabla con las columnas nuevas. Así detectas una sorpresa antes de que llegue a tu hoja de cálculo.
Cómo se reparten las predicciones, antes de descargar
U5Tu tabla puntuada, sin pisar tus columnas
Descargas tu tabla completa con la predicción y, si el modelo la da, su probabilidad. Si ya tenías una columna con ese nombre, la nueva sale con un sufijo, y una celda que parece fórmula se escribe como texto.
Ya había una columna «prediccion»: la nueva sale como prediccion_2
U6El modelo, guardado en un archivo
Guardas el modelo en un solo archivo para usarlo otro día o en otro computador. Lleva lo que aprendió y su constancia, no tus filas; la excepción son los vecinos más cercanos, que guardan filas de entrenamiento, y la app lo dice.
Exportar el modelo: qué lleva el archivo, dicho de frente
U7Un modelo ajeno o alterado no entra
Cuando abres un modelo guardado, la app comprueba primero que sea de Probeta y que esté íntegro, con una huella digital de su contenido. Un archivo ajeno, dañado o manipulado se rechaza con la razón exacta, sin llegar a abrirse.
Un archivo manipulado se rechaza con la razón exacta
U8Qué trae un modelo, antes de usarlo
Antes de usar un modelo importado ves con qué datos nació, qué predice, qué cifra sacó en su prueba, cómo se eligió y qué advertencias trae. Decides con conocimiento, no a ciegas.
Antes de usar un modelo importado, su resumen honesto
U9Puntuar otro día, sin volver a entrenar
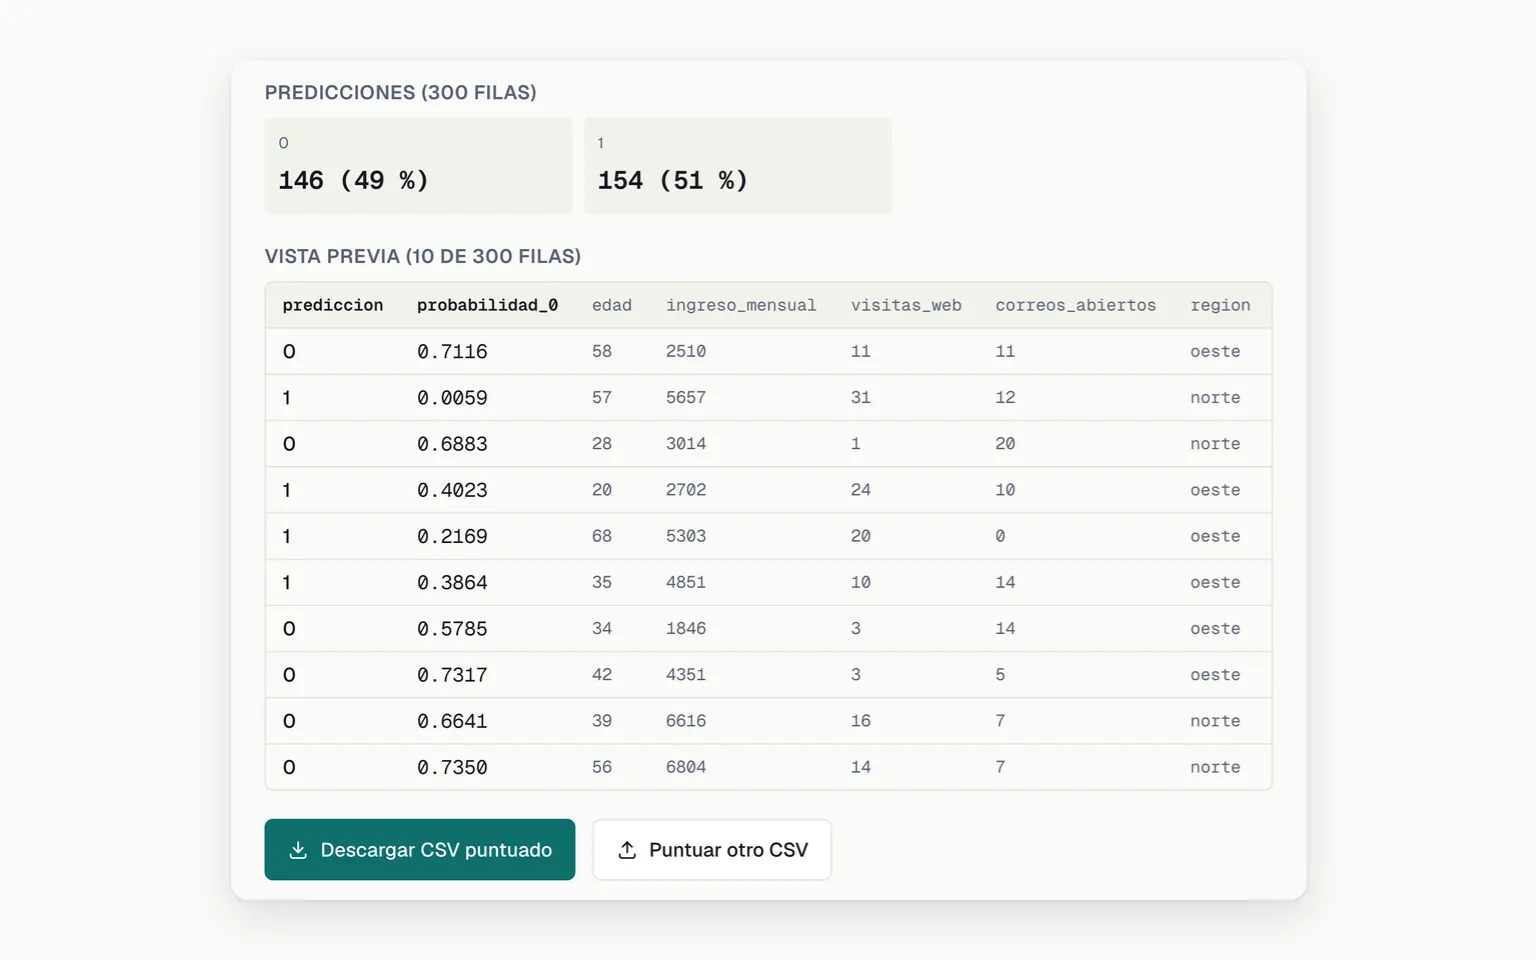
Otro día y en otro computador, abres el archivo del modelo y puntúas tablas nuevas directamente. No necesitas los datos con que se entrenó ni esperar a que vuelva a entrenar.
Un modelo importado puntúa 300 filas nuevas sin volver a entrenar
U10Una receta que reproduce el experimento
Te llevas un archivo de Python con versiones fijas que, con tu CSV, repite el experimento paso a paso y dice si reproduce las mismas métricas. No lleva ni una fila de tus datos.
Llévatelo: qué lleva cada archivo y la receta reproducible
U11El modelo en una página web portátil
Compartes tu modelo como una sola página web: quien la abre arrastra un CSV y su propio navegador lo puntúa, sin servidor y sin costo. La primera vez necesita internet para bajar el motor de cálculo.
El puntuador portátil: una página que puntúa en tu navegador
U12Una plantilla para servirlo a otros sistemas
Si otro sistema necesita consultar tu modelo, descargas un servicio web en Python, con versiones fijas y una guía para mantener el costo predecible. Probeta no despliega nada ni guarda credenciales: tú decides dónde corre.
La plantilla de servicio, para usar el modelo desde otro sistema
U13¿Qué pasaría si?, en dinero
Simulas un cambio, como subir una columna un 10 % en un segmento, y ves cuántas decisiones del modelo se mueven y su costo esperado por cada 100 decisiones, con tus costos. Es una simulación con las probabilidades del modelo, no una medición.
¿Qué pasaría si?: decisiones que cambian y su costo esperado
U14El modelo en reglas, con su fidelidad
Te llevas tu modelo como unas pocas reglas «si… entonces», en texto y en SQL, para usarlo donde no corre Python. La pantalla mide cuánto se parecen al modelo; por debajo de 0,90 de coincidencia no las llama «el modelo en reglas».
El modelo en reglas, con cuánto se parece al modelo
U15Vigilar el desempeño
Con filas nuevas que traen lo que de verdad pasó, comparas la cifra de hoy, con su margen del 95 %, contra la que sacó el modelo en su prueba. El veredicto es claro: sigue, revisar o reentrenar. Los resultados los subes tú.
Vigilar el desempeño: la cifra de hoy frente a la de la prueba
U16Pronosticar una serie
Con una fecha y un número, como las ventas de cada mes, ves qué viene en los próximos periodos, con bandas del 80 y del 95 %. Seis métodos compiten y el veredicto dice si el ganador le gana al mejor método simple.
Pronóstico de una serie, contra el mejor método simple
U17Un gemelo sintético de tus datos
Compartes una muestra sin compartir a las personas: una tabla nueva con la forma de la tuya, que vuelve a sacar toda fila idéntica a una tuya y deja fuera datos personales, identificadores y fechas. Un informe mide el parecido y puede decir «no compartir».
El gemelo sintético y su informe: «se puede compartir»
U18Las reglas, armadas con tu archivo
También un modelo importado, o el ganador del Protocolo, se vuelve reglas: el árbol se arma con las filas de un archivo que subes. Si ese archivo trae el resultado real, fuera del Protocolo las reglas se miden también contra la verdad.
Las reglas armadas con las filas de un archivo tuyo
2.5
2.5 · Grupos, sin nada que predecirCuando no hay nada que predecir, encuentra grupos de filas parecidas y te dice si existen de verdad. · 5 funcionalidades
AbrirCerrar
Qué resuelve
Cuando no hay nada que predecir, encuentra grupos de filas parecidas y te dice si existen de verdad.
Sus piezas 5
G1Agrupar filas parecidas, sin objetivo
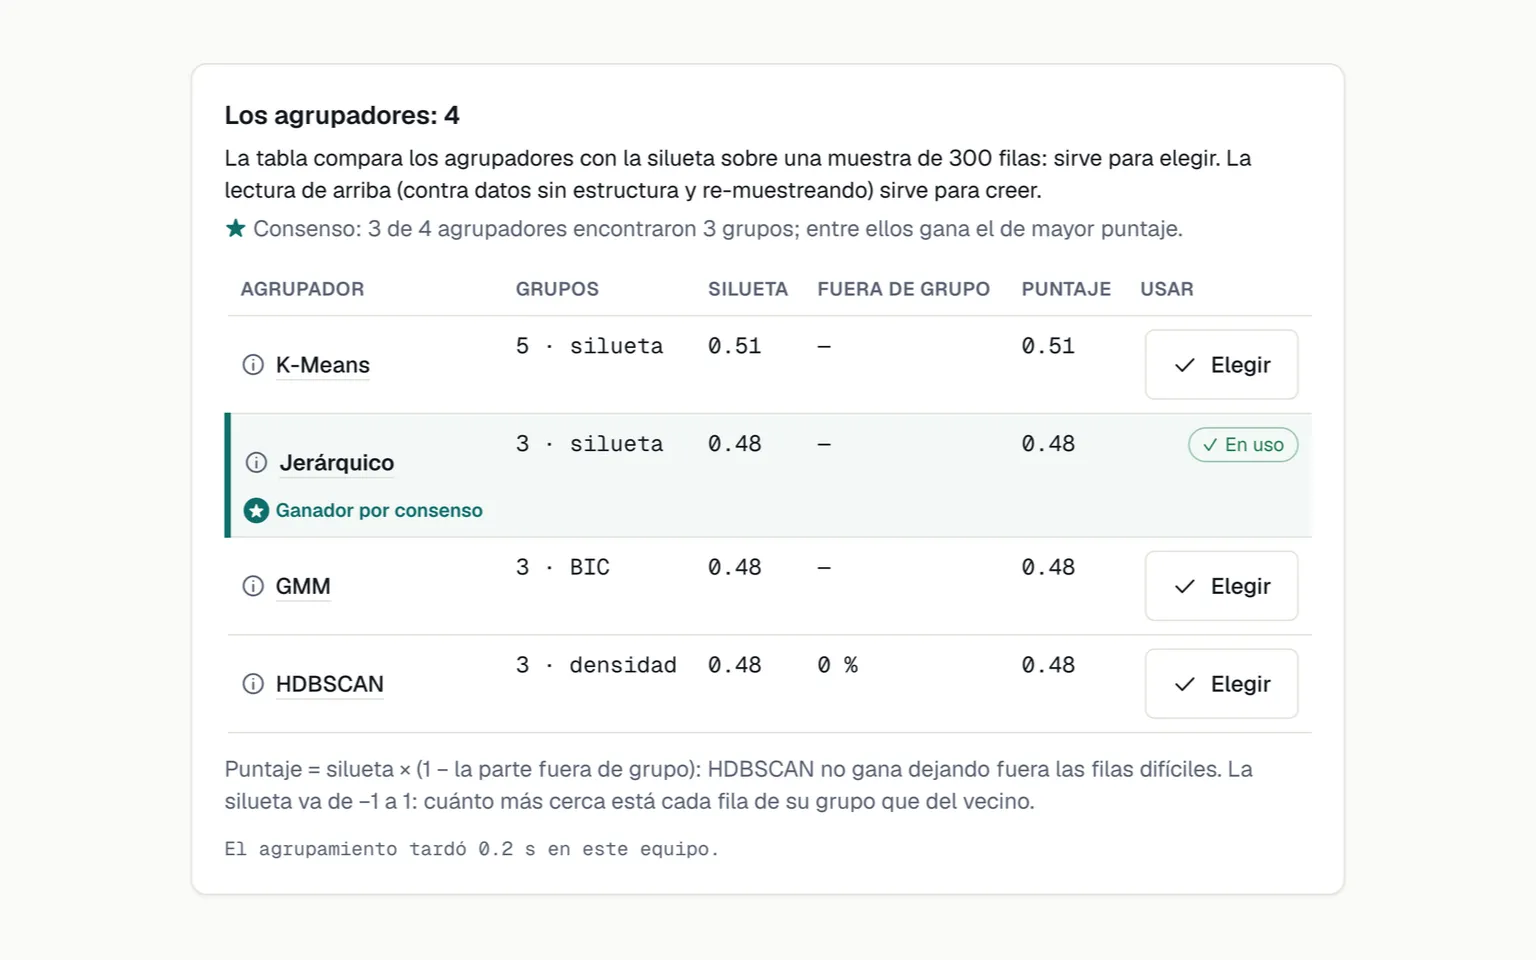
Descubres si tus clientes, productos o casos forman grupos: cuatro agrupadores, como K-Means, buscan los grupos y eligen cuántos con un criterio medido. Cada uno dice cómo eligió, y gana el número de grupos en que más coinciden.
Los agrupadores compiten y cada uno dice cómo eligió
G2Te dice si los grupos existen
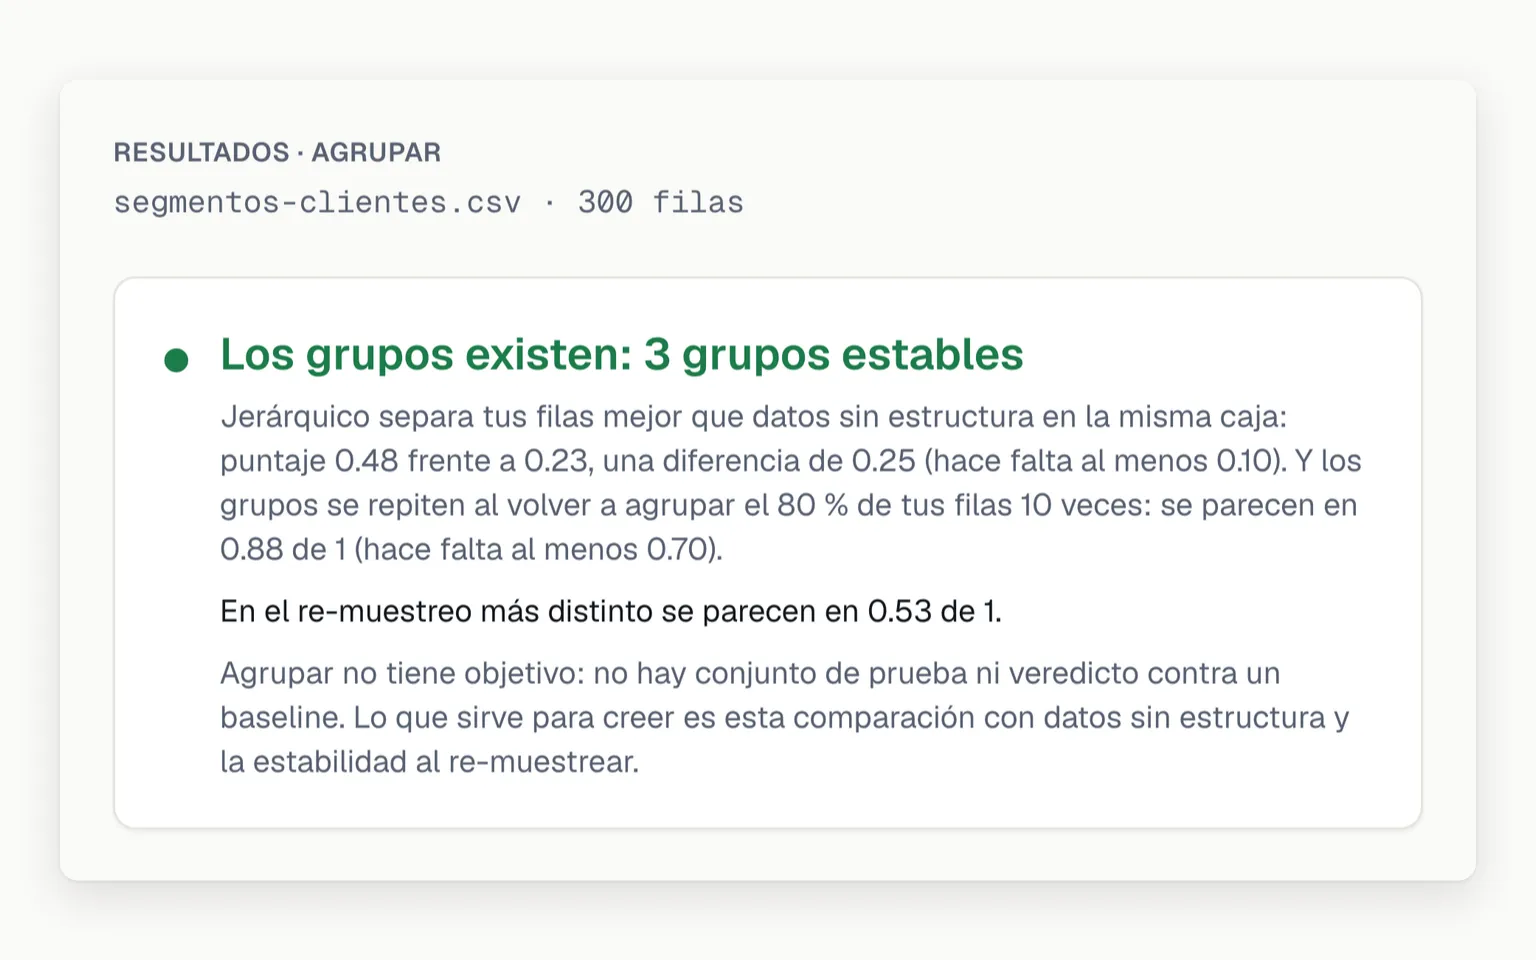
Sabes si tus grupos son un hallazgo o solo una forma de partir la tabla: la app los compara con datos al azar y repite el agrupamiento sobre partes de tus filas. La lectura es ● existen, ⚠ frágiles u ○ sin estructura.
La lectura: los grupos existen, comprobado contra el azar
G3Qué distingue a cada grupo
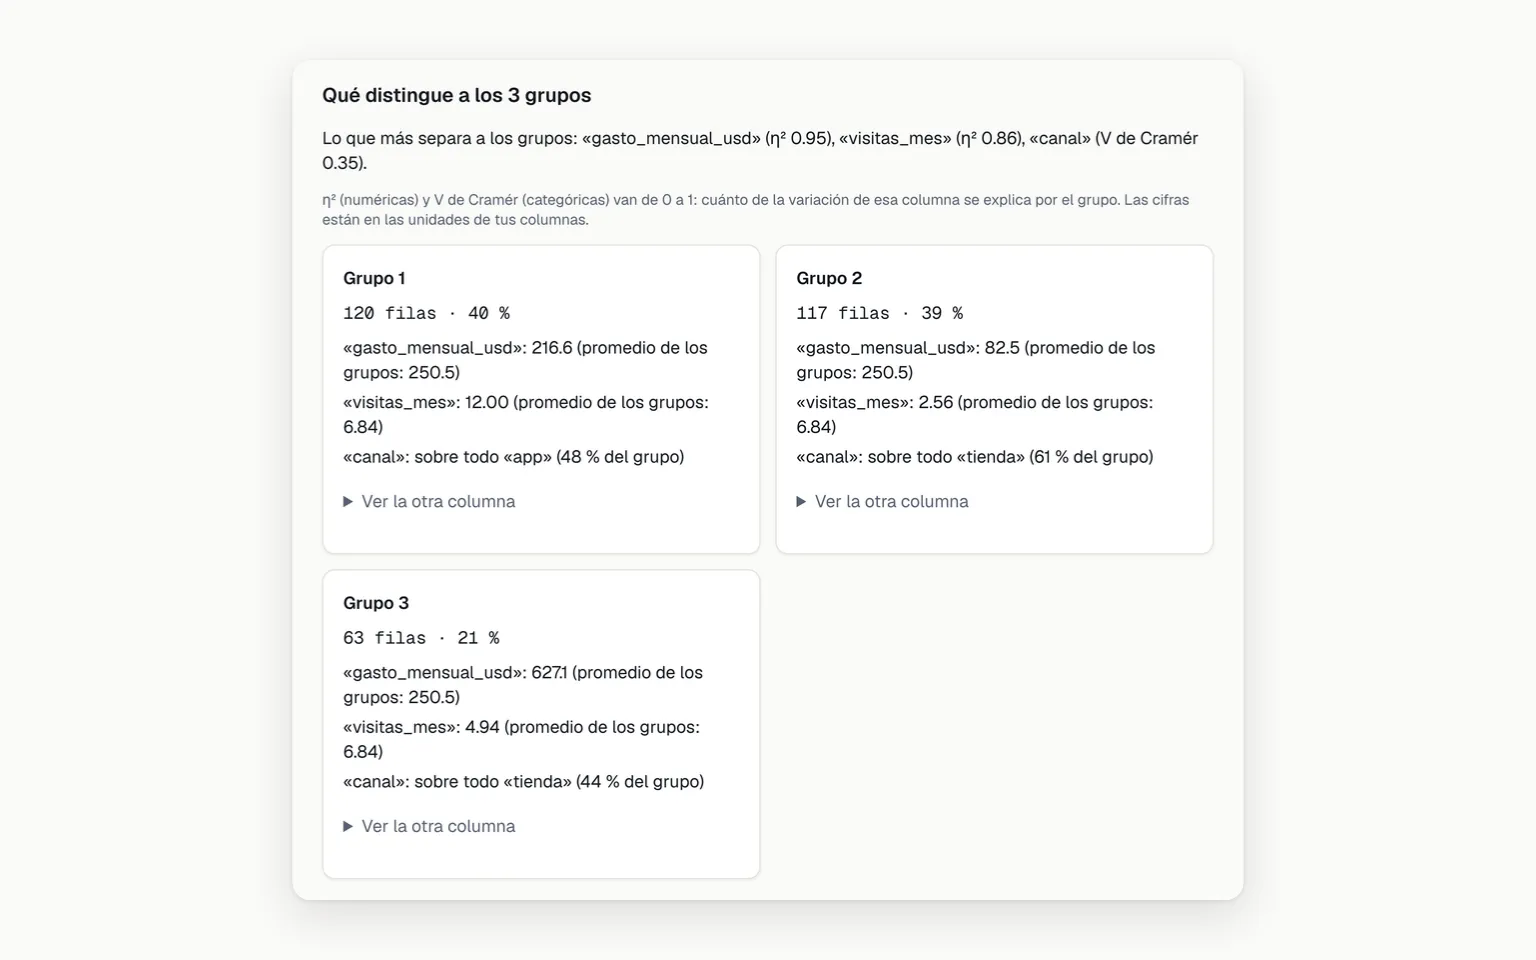
Cada grupo llega con su tamaño y las columnas que más lo separan, en las unidades de tu tabla y frente al promedio de todos. Las filas que no caen en ningún grupo aparecen aparte, sin forzarlas.
Qué distingue a cada grupo, en las unidades de tu tabla
G4Tus filas con su grupo
Descargas tu tabla entera con una columna más que dice a qué grupo pertenece cada fila. Se arma en tu navegador en el momento y no se guarda en ningún otro lado.
Tus filas con su grupo, armadas en tu navegador
G5Asignar filas nuevas a un grupo
Clasificas filas nuevas en los grupos que ya encontraste, con una regla dicha, como el centro más cercano o «fuera de todo grupo». El archivo del modelo lleva esa regla y ninguna de tus filas.
Filas nuevas asignadas a un grupo, con la regla dicha
2.6
2.6 · Protocolo DS: diez etapas sin atajosEl camino lento, con tus propios datos: compuertas que no se saltan y una ficha del modelo que se escribe sola. · 19 funcionalidades
AbrirCerrar
Qué resuelve
El camino lento, con tus propios datos: compuertas que no se saltan y una ficha del modelo que se escribe sola.
Sus piezas 19
L1Una compuerta que no se salta
Avanzas solo cuando cumples: ninguna etapa se abre sin el criterio de salida de la anterior, verificado por código o por tu respuesta escrita. No existe un botón para saltar; una etapa se cumple o se corrige.
Diez etapas: cada una abre solo cuando cumples la anterior
L2Un cuaderno que se escribe solo
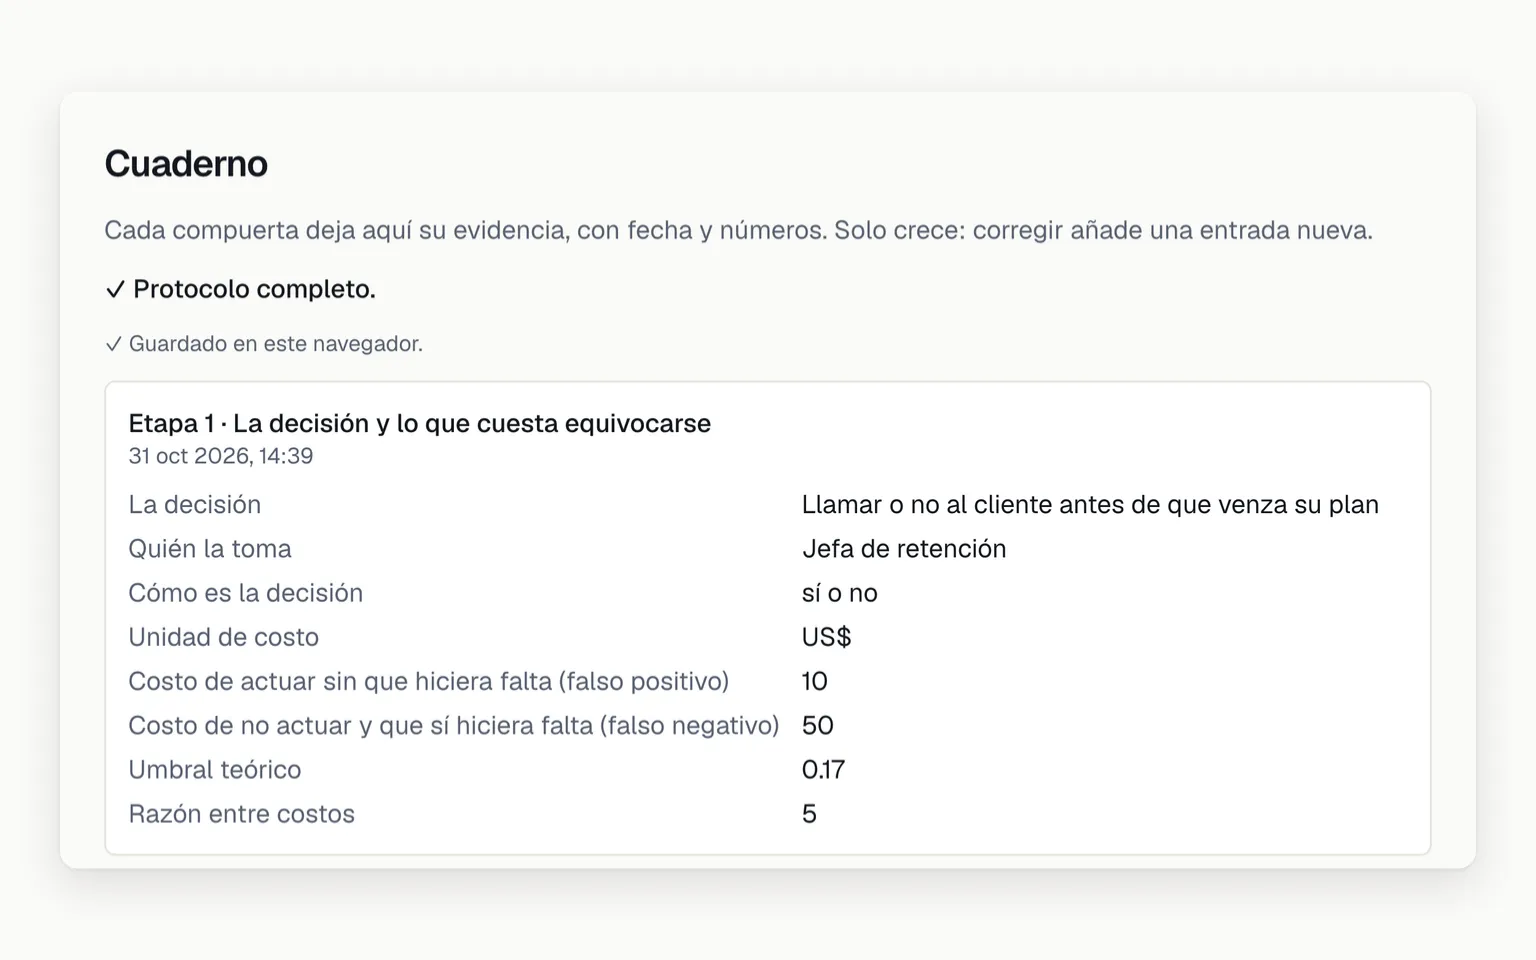
Cada etapa cumplida deja su evidencia en un cuaderno que vive en tu navegador, atado a la huella de tu archivo, un código que sale de su contenido exacto. Lo exportas y lo importas sin una sola fila de tus datos.
El cuaderno: la evidencia de cada etapa, sin filas de tus datos
L3Cada etapa te muestra la trampa que evitas
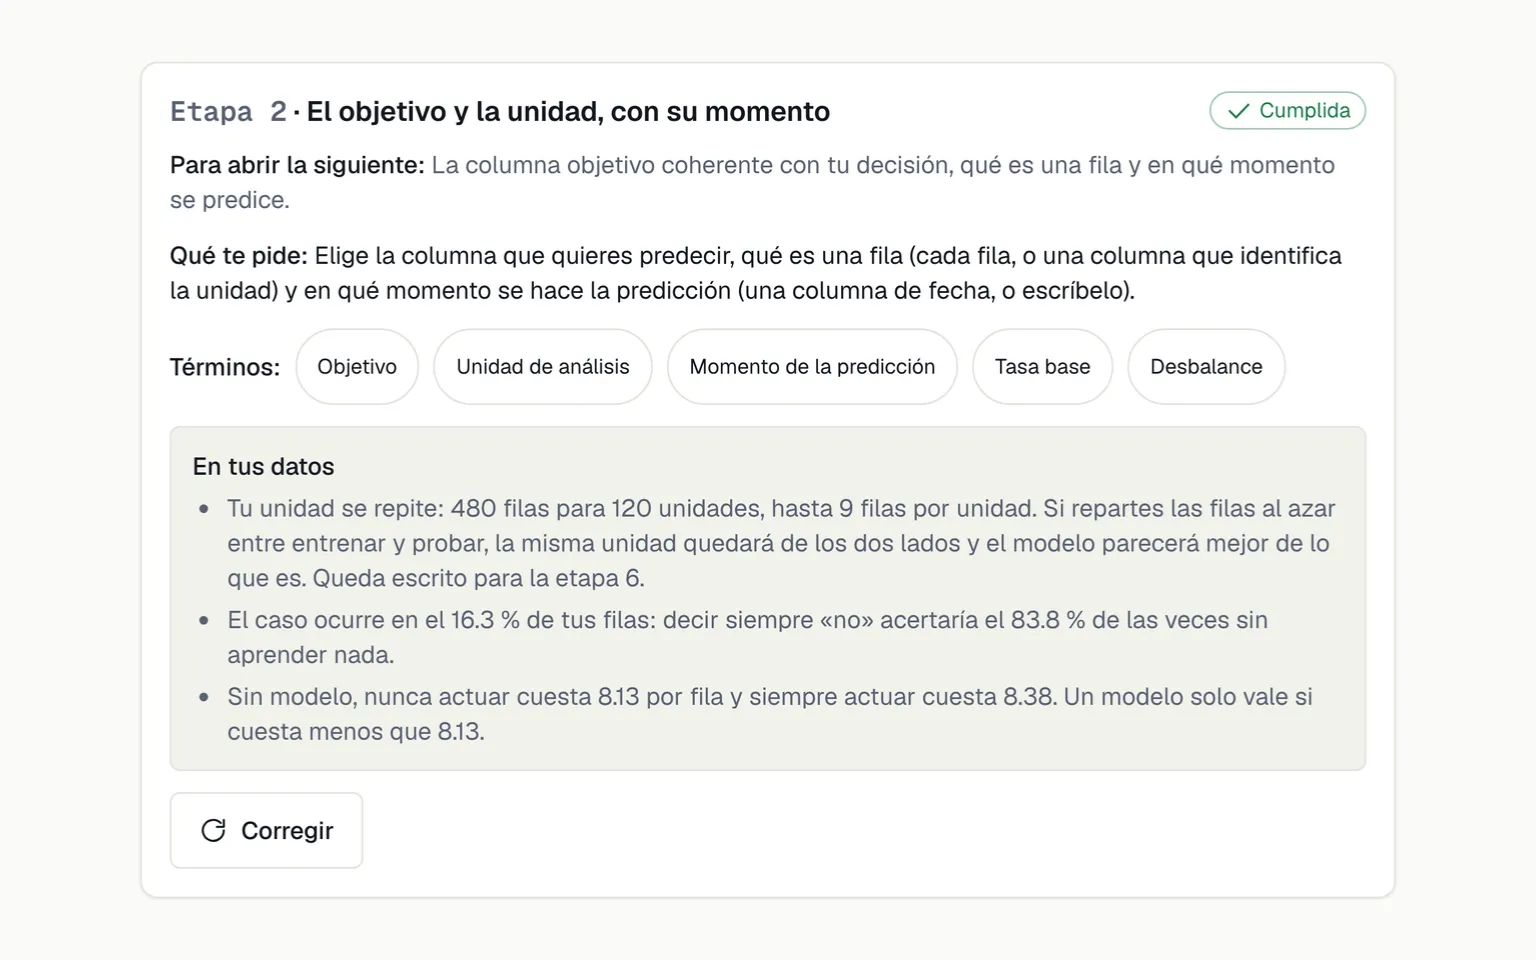
Aprendes por qué existe cada etapa viendo, en tus propios datos, la trampa que acabas de evitar, como «tu unidad se repite: 361 filas para 100 unidades». No es un curso con datos ajenos.
«En tus datos»: la trampa que la etapa acaba de evitar
L4Un glosario a un clic
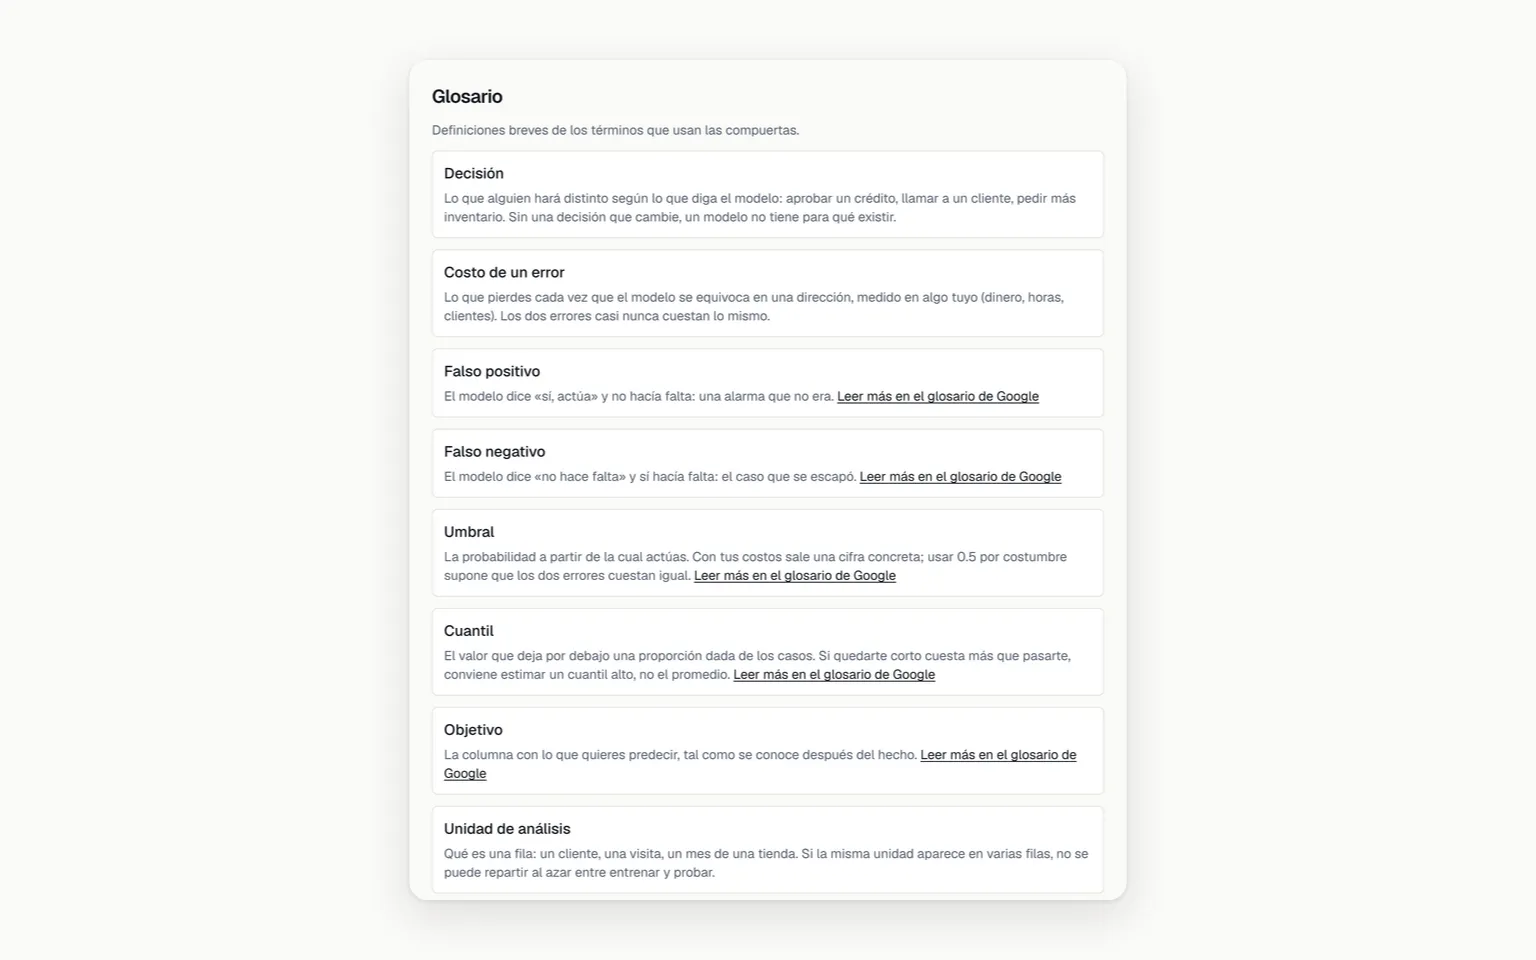
Cada término técnico de una etapa enlaza a una definición breve y propia, al pie de la página. Donde existe, también te lleva a la entrada del glosario de aprendizaje automático de Google.
El glosario, a un clic de cada término
L5La decisión y lo que cuesta equivocarse
Empiezas por el negocio, no por el modelo: nombras la decisión, quién la toma y cuánto cuesta cada error. De ahí sale desde qué probabilidad conviene actuar, que no siempre es 0,5.
La decisión y sus costos: desde qué probabilidad actuar
L6El objetivo y la unidad, con su momento
Defines qué es una fila, qué predices y en qué momento se conoce. La app lo comprueba en tus datos, cuenta cuántas filas tiene cada unidad y, si una fecha es ambigua, te pregunta en vez de adivinar.
El objetivo, la unidad y el momento, comprobados en tus datos
L7¿Predecir o explicar?
Si lo que buscas es una causa, el Protocolo se detiene y te lo dice: eso pide un experimento, no un modelo predictivo. Puedes reformular tu pregunta como una predicción y seguir.
¿Buscas una causa? El Protocolo te recuerda que eso pide un experimento
L8Cuántas filas hacen falta, con sus supuestos
Escribes la población, el periodo y las exclusiones, y la app calcula cuántas filas hacen falta para tus variables, diciendo qué supone. Si no te alcanzan, no te frena: te pide un aviso escrito que queda en el cuaderno.
Cuántas filas hacen falta, con lo que el cálculo supone
L9¿Existe al decidir? Columna por columna
Declaras, columna por columna, quién la produce y si se conoce antes o después de decidir. Lo que se llena después solo se puede excluir, y lo que no sabes no entra al modelo.
Columna por columna: quién la produce y cuándo se conoce
L10Apuesta dónde está la fuga
Antes de ver lo que encontró la app, apuestas qué columnas crees que filtran el resultado. Al revelar, tu apuesta queda fija y una comparación te muestra qué acertaste y qué te sorprendió.
Tu apuesta frente a lo que encontró la app
L11La vara sin modelo y la regla de hoy
Mides lo que ya se logra sin modelo, en costo por cada 100 decisiones, y la regla que tu gente aplica hoy, medida en tus filas. Es la vara que cualquier modelo tendrá que superar.
La línea base sin modelo y tu regla de hoy, en costo
L12Una prueba sellada, según tu caso
La app aparta tu prueba según tu caso, por tiempo, por grupo o al azar estratificado, y te explica por qué. Verifica que nada se cruce entre lados y sella la prueba con una huella antes de entrenar.
La prueba por tiempo y por grupo, con su hueco y sin cruces
L13La liga, con la prueba cerrada
Los modelos compiten solo dentro del entrenamiento, con pliegues que respetan tu partición y heredan tus decisiones. El ganador se compara con la línea base, con un intervalo del 95 %, y la prueba sigue cerrada.
La liga dentro del entrenamiento, con la prueba cerrada
L14¿Hay señal real, o es azar?
Sabes si el modelo encontró estructura o solo azar: una prueba de permutación baraja las etiquetas muchas veces y vuelve a validar al ganador. Te da el valor p con su resolución, que depende de cuántas veces barajó.
¿Señal o azar? La prueba de permutación con su valor p
L15Dónde falla, con la prueba abierta una vez
La prueba se abre una sola vez y ves dónde falla el modelo: el peor segmento, si sus probabilidades dicen la verdad y los diez casos más caros. Con eso escribes el patrón de fallo, y cada apertura distinta queda contada.
La prueba abierta una vez: el error por segmento
L16¿Sirve para la decisión?
El modelo se traduce a tu decisión: alertas y falsas alarmas por cada 100 casos, costo y beneficio frente a lo que haces hoy. Decides usarlo, iterar o no usarlo; «no usarlo» es un resultado válido y queda escrito.
¿Sirve para la decisión? Alertas, costo y beneficio por cada 100
L17La ficha del modelo y su vigilancia
Te llevas la ficha del modelo, armada sola desde el cuaderno, con la etapa y la huella de cada línea. Si decides usarlo, trae el plan de vigilancia, quién responde, cada cuánto se reentrena y un chequeo de si las entradas cambian.
La ficha del modelo, armada sola desde el cuaderno
L18¿Qué pasaría si?, sin abrir la prueba
En la etapa de la decisión simulas cambios con tus costos usando solo las filas de entrenamiento, así que la prueba no se vuelve a abrir. Lo simulado informa tu decisión, pero no entra al cuaderno ni a la compuerta.
¿Qué pasaría si? en la etapa 9, sin volver a abrir la prueba
L19El ganador, listo para usarse
Si decides usarlo, guardas el ganador como un archivo que Probeta abre para puntuar filas nuevas y vigilar su desempeño. Lleva la cifra de su prueba, se reajusta solo con el entrenamiento y, salvo con vecinos más cercanos, no lleva filas tuyas.
El ganador del Protocolo, guardado para puntuar y vigilar
2.7
2.7 · En toda la appLo que acompaña a cada pantalla: dos idiomas completos y un diccionario para cada término. · 2 funcionalidades
AbrirCerrar
Qué resuelve
Lo que acompaña a cada pantalla: dos idiomas completos y un diccionario para cada término.
Sus piezas 2
Sin pantalla propia
T1Bilingüe español e inglés
Usas toda la interfaz en español o en inglés, con un conmutador en la esquina superior. Hay pruebas automáticas que fallan si un texto existe en un idioma y falta en el otro.
Atraviesa toda la app.
Sin pantalla propia
T2Diccionario de términos
Cuando una palabra te frena, el manual de uso la explica en una línea: línea base, veredicto, fuga, desbalance, importancia, novedad y cada métrica de clasificar, estimar y agrupar.
Atraviesa toda la app.
03
03 · De punta a punta
03 · Un modelo que se pueda defender
El camino completo. Sin carriles: cada caja dice quién la hace, y las que llevan el ícono de pantalla la muestran.
InicioPasoDecisiónA la vezFinQuien defiende el modeloProbeta · en el navegadorCon pantalla
Inicio · Quien defiende el modelo: Un dataset y una preguntaUn dataset y una pregunta1
Paso · Quien defiende el modelo: Carga el dataset en el navegadorQuien defiende el modeloCarga el dataset en el navegador2
Paso · Probeta · en el navegador: Perfila y sanea los datosProbeta · en el navegadorPerfila y sanea los datos
Paso · Quien defiende el modelo: Elige qué quiere predecirQuien defiende el modeloElige qué quiere predecir
Paso · Probeta · en el navegador: Parte en entrenamiento y pruebaProbeta · en el navegadorParte en entrenamiento y prueba
Paso · Probeta · en el navegador: Ajusta el preprocesamiento con entrenamientoProbeta · en el navegadorAjusta el preprocesamiento con entrenamiento3
Paso · Probeta · en el navegador: Entrena y compara con el baselineProbeta · en el navegadorEntrena y compara con el baseline
Decisión · Probeta · en el navegador: ¿Supera?Probeta · en el navegador¿Supera?4
Paso · Quien defiende el modelo: Lee el veredicto honestoQuien defiende el modeloLee el veredicto honesto
Paso · Probeta · en el navegador: Cuenta el porqué, con cifras de pruebaProbeta · en el navegadorCuenta el porqué, con cifras de prueba
Paso · Quien defiende el modelo: Usa el modelo y lo defiendeQuien defiende el modeloUsa el modelo y lo defiende
Fin
no superasícorrige su tabla
Notas del proceso
1Un dataset y una pregunta. ¿Prefiere el camino lento? Protocolo DS recorre lo mismo en diez etapas con compuertas que no se saltan.
2Carga el dataset en el navegador. El dataset nunca se sube: perfilado, entrenamiento y scoring corren en el navegador con Pyodide.
3Ajusta el preprocesamiento con entrenamiento. La prueba no contamina el entrenamiento: el preprocesamiento aprende solo de él y la interfaz no ofrece otro camino.
4¿Supera?. Cuatro veredictos: ▲ supera, = empata, ▼ NO supera y ⚠ sospechoso, cuando una columna adivina demasiado bien.
04
04 · Hecho con método
Cada cifra dice de dónde sale. Y lo que la app no hace también está dicho.
Las cifras, con su procedencia
77Funcionalidades●medido¿De dónde sale?
Contadas contra docs/MANUAL-DE-USO.md (58 de Probeta y 19 de Protocolo DS); el pie de docs/BROCHURE.html declara el mismo número (export de la app en 988489c, 2026-10-28). Las 37 de la VISION están construidas y ninguna está descartada: nada se descarta sin una decisión escrita del usuario.
5Pantallas del recorrido●medido¿De dónde sale?
StartScreen, ConfigScreen, TrainingScreen, ResultsScreen y ScoreScreen en src/components/. ErrorScreen no cuenta: es un estado de error, no un paso. Probeta es un solo espacio de trabajo (un page.tsx); Protocolo DS vive aparte en /protocolo. La ruta /conoce sirve el brochure y no es una pantalla del producto.
10Etapas del Protocolo●medido¿De dónde sale?
Las diez etapas con compuerta de Protocolo DS, construidas (src/engine/protocolo/etapa1.ts a etapa10.ts); cada una con su criterio de salida verificado por código. Lo recuenta tests/unit/brochure-export.test.ts.
3.461Pruebas unitarias y de integración●medido¿De dónde sale?
Salida del 2026-10-28 sobre el árbol final del S21 (988489c): `pnpm test` 3114 pruebas en 174 archivos + `pnpm test:integration` 347 en 25 archivos (con Pyodide real; 10 más se saltan a propósito: las mediciones con `MEDIR=1` y el emisor del fixture del S6). Aparte, 23 pruebas de Python en CPython 3.14.0 que corre el job `integration` (el servicio, la receta y el SQL).
183Pruebas end-to-end●medido¿De dónde sale?
Salida de la suite e2e entera el 2026-10-28 sobre 988489c, en el build de producción y con `--retries=0`: 41 specs de Playwright sobre 2 dispositivos, con axe en los dos temas; 183 pasan y 13 se omiten a propósito (Tab no aplica al teléfono; el puntuador se prueba una vez en escritorio; las dos mediciones del S21 solo corren con `MEDIR=1`). Cero fallos y cero reintentos.
95,35%Cobertura de líneas●medido¿De dónde sale?
v8 sobre engine, lib, components y workers; 12169 de 12762 líneas (salida de `pnpm test` del 2026-10-28 sobre 988489c: imprime 95,35 %). Los motores puros de engine/ llevan umbral propio más alto.
9Dependencias en tiempo de ejecución●medido¿De dónde sale?
next, react, react-dom, zod, pino, @sentry/nextjs, @sentry/browser (el cliente liviano de la misma versión, ADR 018), ai y @ai-sdk/groq. El motor de ciencia de datos (pandas y scikit-learn) no está aquí: viaja como WebAssembly y corre en el navegador. Lo recuenta tests/unit/brochure-export.test.ts contra package.json.
0Filas de datos del usuario que salen del navegador●medido¿De dónde sale?
Veinticuatro specs e2e vigilan las peticiones de red (contadas el 2026-10-28 sobre 988489c: las de Probeta, también la pregunta a tus datos, y las de las etapas 4 a 10 del Protocolo): fallan si una lleva valores del dataset o, sin consentimiento, una petición de narración. Lo único que sale con contenido del usuario es la narración con IA, a petición y solo con agregados: 652 B medidos.
0GPU requerida◆declarado¿De dónde sale?
Regla dura del producto: 100 % CPU. Árboles y boosting sobre scikit-learn en WebAssembly; prohibidos los modelos fundacionales tabulares, el backend WebGPU y el entrenamiento pesado de deep learning.
US$0Costo de operación mensual▲calculada¿De dónde sale?
Suma de los servicios contratados: Vercel Hobby (US$0), GitHub repo público (US$0), Sentry free tier (US$0) y Groq dentro de su cuota gratuita (la narración es opt-in y cuesta ~US$0.0005 por uso, registrado por Pino). No hay base de datos que facturar.
134KBPeso de este brochure●medido¿De dónde sale?
`wc -c docs/BROCHURE.html` en 988489c, 2026-10-28 (lo recuenta tests/unit/brochure-export.test.ts). Archivo autocontenido: cero CDN y cero peticiones de red, verificado instrumentando el navegador.
30Decisiones de arquitectura registradas●medido¿De dónde sale?
Archivos de decisions/ en 988489c, 2026-10-28 (001–030): el 023 y el 024 son la prueba de estrés y lo que el usuario se lleva; el 025 y el 026, el lector de Excel y el plan de limpieza; el 027, del modelo a la decisión; el 028, pronosticar una serie; el 029, el gemelo sintético; el 030, preguntarle a tus datos. Lo recuenta tests/unit/brochure-export.test.ts.
Con qué está hecha
Next.js + TypeScriptla app, en modo estricto y bilingüe desde el primer día
Pyodide (WebAssembly)pandas y scikit-learn corriendo dentro del navegador, en un Web Worker, self-hosteados
scikit-learnel pipeline anti-fuga, la liga de modelos candidatos y los baselines contra los que se juzga
IndexedDBel cuaderno del Protocolo vive en el navegador de quien lo usa, nunca en un servidor
Vitest y Playwrightlas pruebas, incluidas las que fallan si alguien ajusta el preprocesamiento fuera de la parte de entrenamiento
Groqla narración del porqué: opt-in, con guardrails y fallback determinista si falla
Sentry y Pinoobservabilidad de metadatos — nunca contenido del dataset
Tus datos
✓Probeta se sirve desde la web, pero tus datos se quedan en tu equipo: el perfilado, la limpieza, el entrenamiento y la puntuación corren en tu navegador, y tu tabla nunca se sube a un servidor.
✓Solo sale algo si pides la narración con IA: los nombres de tus columnas y cifras agregadas (652 bytes en una medición real), jamás filas.
✓Los errores reportan solo metadatos, como cuántas filas y columnas hay, nunca valores.
✓El cuaderno de Protocolo DS vive en el almacenamiento de tu navegador y sale solo si tú lo exportas; ese modo es todo código determinista, sin IA generativa.
Lo que nunca hace
✕Sube tu tabla a un servidor.
✕Ajusta el preprocesamiento con las filas de prueba.
✕Maquilla un veredicto: si no le gana a la regla simple, dice «NO supera».
✕Rellena en silencio una columna que falta para poder puntuar.
✕Necesita una tarjeta gráfica.
Sus límites, dichos
!Archivos de hasta 5 MB o 50 000 filas, y todo en CPU dentro del navegador: una liga grande puede tardar minutos.
!El chequeo de fuga atrapa los casos evidentes, una columna a la vez: es una ayuda honesta, no una garantía.
!No es una app local: se sirve desde la web, con una sola ruta de servidor para la narración con IA, que nunca recibe filas.
!Explica qué pesa en el modelo, no qué causa qué: una causa pide un experimento, y el Protocolo se detiene si la buscas.