Probeta DS
Construye un modelo que puedas defender.
Traes una tabla, eliges qué quieres predecir, y la app entrena un modelo de verdad dentro de tu navegador — y te dice con franqueza si sirve o no. Sin ser científico de datos, sin escribir código y sin una sola tarjeta gráfica.
Para quién
Para el profesional que no es científico de datos —analistas, financieros, investigadores aplicados— y que tiene que defender un modelo ante su jefe o su comité, no ganar un leaderboard.
Qué no hace nadie más
Entrenar un modelo lo hacen muchas herramientas. Lo que no hace ninguna es enseñar la pantalla en la que su propio producto falla: el veredicto contra el baseline dice «NO supera» cuando no supera, la fuga de datos es imposible por construcción (el preprocesamiento se ajusta solo con la mitad de entrenamiento y la UI no ofrece otro camino), y toda cifra sale del conjunto de prueba. El incentivo del mercado es el optimismo; aquí es la honestidad.
Las cifras
33funcionalidades
Funcionalidades del H1
medido5pantallas
Pantallas del recorrido
medido267pruebas
Pruebas unitarias y de integración
medido24pruebas
Pruebas end-to-end
medido90,69%
Cobertura de líneas
medido8paquetes
Dependencias en tiempo de ejecución
medido0filas
Filas de datos del usuario que salen del navegador
medido0GPU
GPU requerida
declarado0USD
Costo de operación mensual
calculada61.572bytes
Peso de este brochure
medido8ADR
Decisiones de arquitectura registradas
medido
Qué hace
33 funcionalidades, agrupadas. Cada tarjeta se abre sola al llegar leyendo — y si la tocas, manda tu toque.
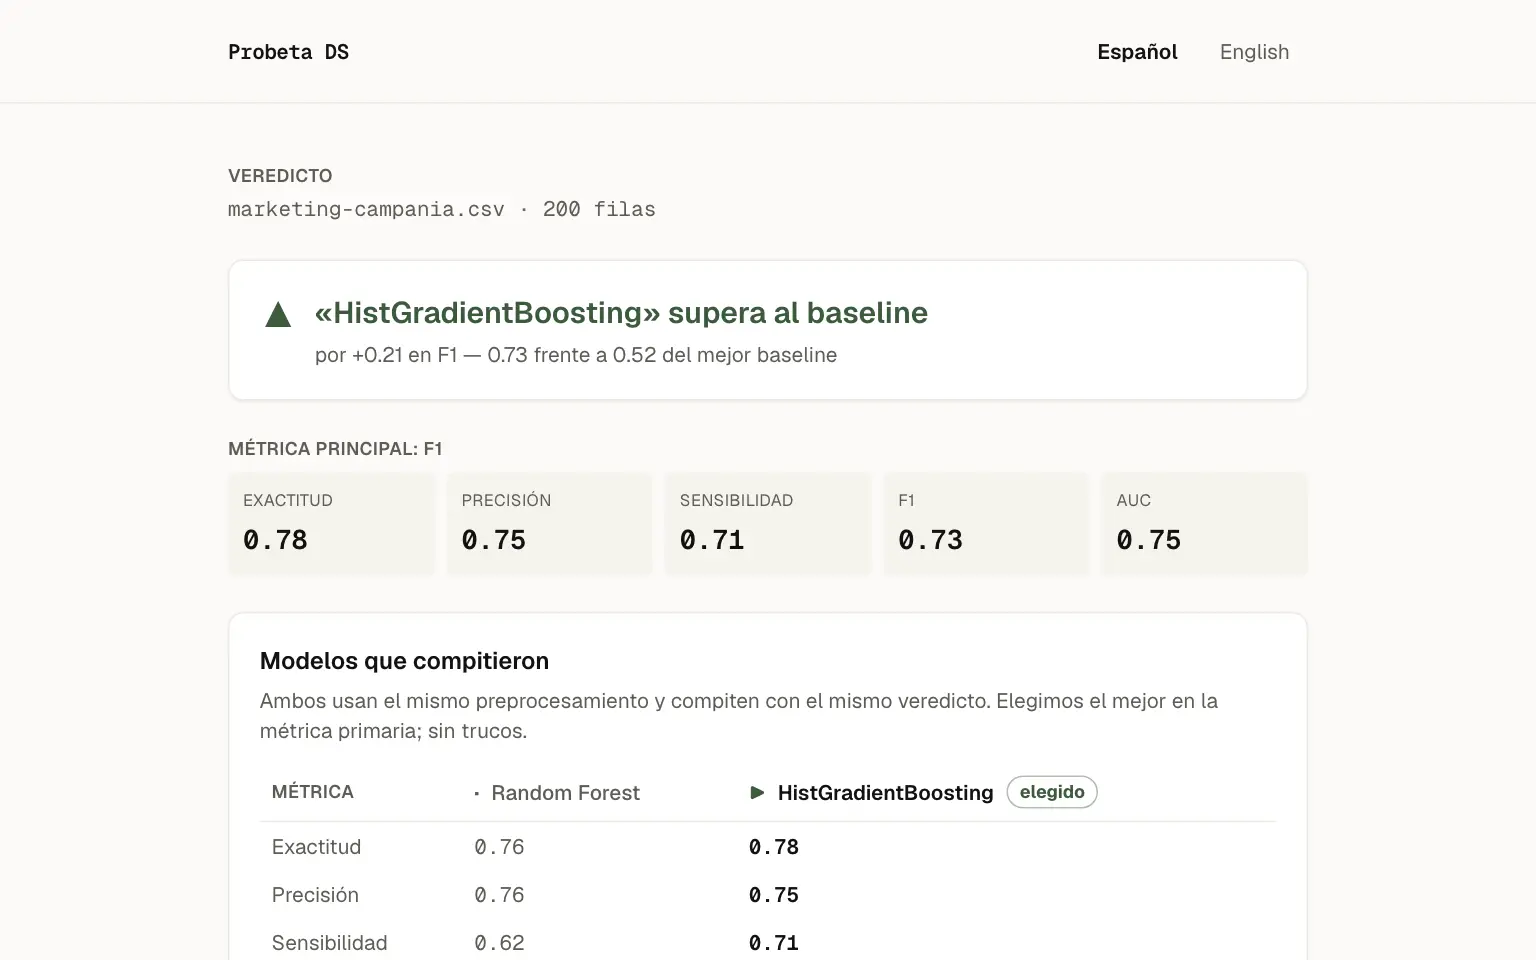
Eliges qué predecir
Seleccionas la columna objetivo, que debe tener exactamente dos categorías (sí/no, 0/1, aprobado/rechazado).
Entrenamiento con el progreso a la vista
El motor corre en el navegador y muestra el avance paso a paso, sin pantallas en blanco.
El veredicto contra el baseline
▲ supera · = empata · ▼ NO supera, con el número exacto de la diferencia. Si el modelo no aporta, se dice de frente.
Aviso de métricas casi perfectas
Un resultado redondo casi siempre esconde una fuga, no un gran modelo. La app lo marca como sospechoso en vez de celebrarlo.
Advertencia de fuga con la columna nombrada
Señala por nombre la columna que podría ser un proxy del objetivo, y qué hacer con ella.
Cinco métricas, todas sobre datos no vistos
Exactitud, precisión, sensibilidad, F1 y AUC, calculadas siempre sobre el conjunto de prueba.
Matriz de confusión
En qué se equivoca el modelo, no solo cuánto.
Los baselines, a la vista
Clase mayoritaria y regresión logística: los rivales que hay que batir, con sus cifras.
Dos modelos compiten y se dice cuál ganó
Random Forest y HistGradientBoosting, mismo preprocesamiento y mismo veredicto. No elige el usuario: habla el resultado.
Nuevo experimento
Un botón devuelve la app al inicio para volver a empezar.
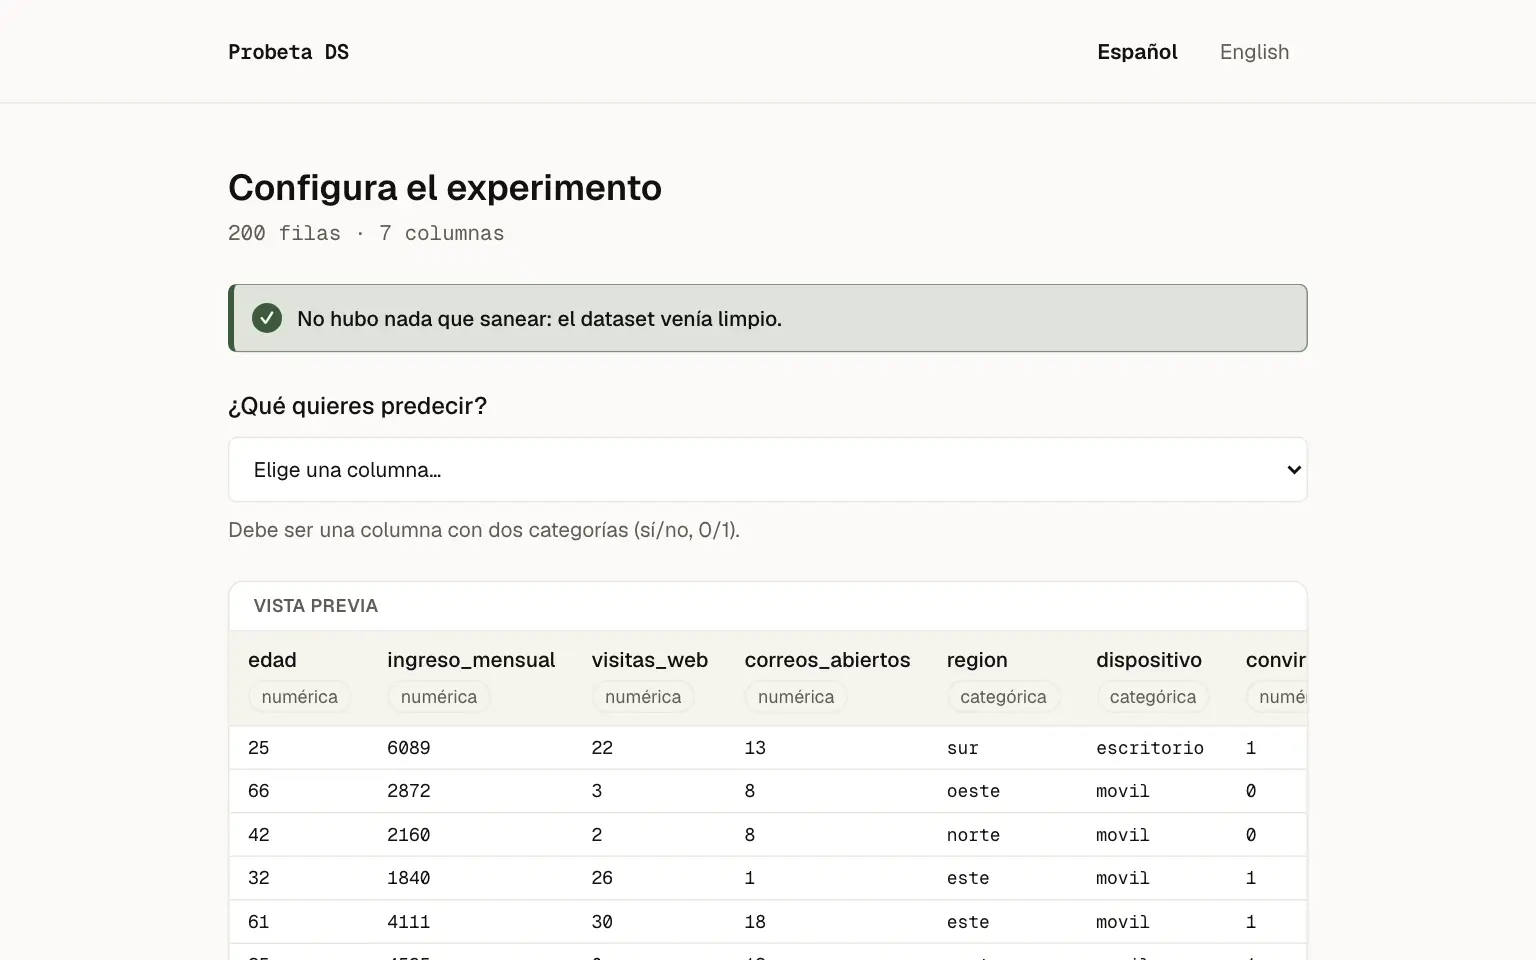
Subir tu propio CSV
Arrastrando o eligiendo el archivo. El dataset se queda en el equipo de quien lo sube.
Tres ejemplos incluidos
Datos sintéticos empaquetados para recorrer la app entera sin traer nada propio.
Vista previa con el perfil de cada columna
Tipo, valores vacíos y aviso cuando algo parece una fecha.
Límites dichos de frente
5 MB o 50 000 filas. Por encima avisa; no se cuelga fingiendo que trabaja.
Saneamiento transparente con el conteo exacto
Filas duplicadas eliminadas, columnas identificadoras o constantes apartadas, celdas basura vaciadas. Y si el dataset venía limpio, un franco «nada que sanear».
Tres alertas antes de entrenar
Columna que huele a fuga, columna que parece un identificador y objetivo desbalanceado. Con símbolo y texto, nunca solo color.
Bloqueo del CSV con separador equivocado
El caso típico de Excel en español: se nombra el separador real en vez de adivinarlo, porque una lectura adivinada convertiría columnas numéricas en categorías en silencio.
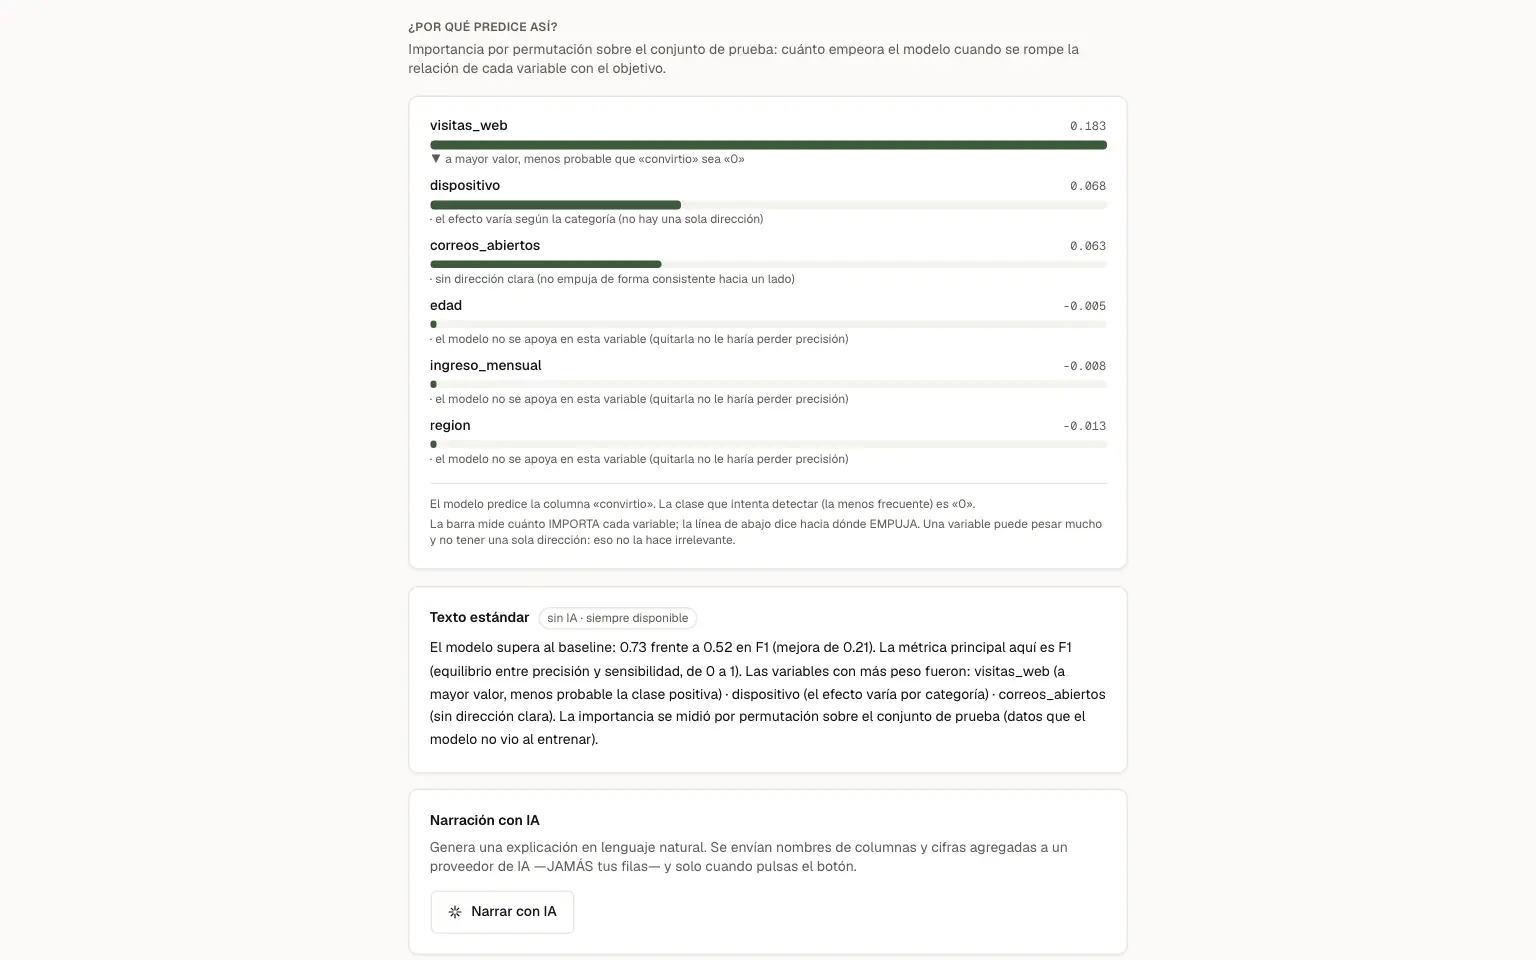
Gráfico de importancia con dirección
Importancia por permutación sobre el conjunto de prueba. Si el modelo no se apoya en una variable, se dice así: no se le pinta una flecha que la medición no respalda.
Texto explicativo sin IA y sin internet
Lo genera la propia app con los números del experimento. Siempre está disponible.
Narración con IA, solo a petición
Marcada «✓ verificada con los números»: si cita una cifra o una variable que no existe, se descarta antes de mostrarse.
Aviso honesto si la narración falla, con reintento
Dice cuál de los motivos ocurrió: el proveedor no respondió, no pasó la verificación, o no está configurada.
Model card descargable
La ficha completa del experimento: datos, partición, método, métricas, veredicto y límites.
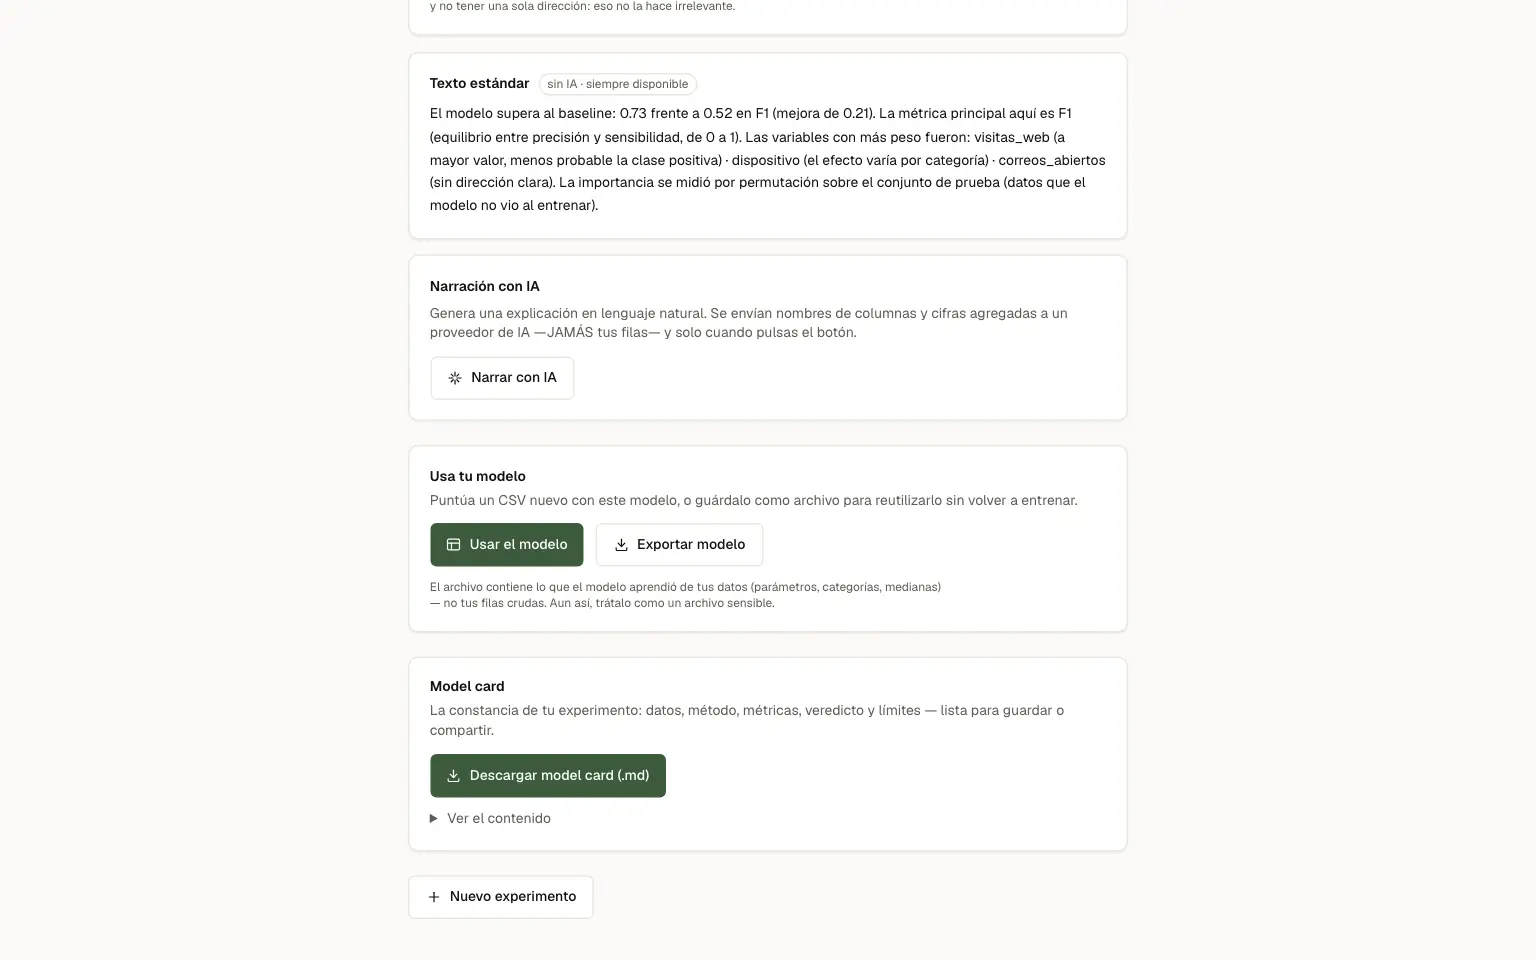
Puntuar datos nuevos
Se sube otra tabla y se obtiene la predicción de cada fila.
Bloqueo honesto por columnas faltantes
Si falta alguna columna del modelo, se niega a puntuar y dice exactamente cuáles. Nunca rellena en silencio.
Aviso de novedad con el porcentaje de filas
Valores que el modelo nunca vio al entrenar: se declara en cuántas filas está adivinando.
Distribución de predicciones y vista previa
Antes de descargar nada.
CSV puntuado sin pisar columnas
La tabla completa más predicción y probabilidad; si ya existía una columna con ese nombre, la nueva sale con sufijo.
Exportar el modelo a un archivo
Lo que aprendió y su constancia, no las filas del usuario.
Importar validando la integridad
Un archivo ajeno, corrupto o manipulado se rechaza con la razón exacta, sin llegar a abrirse.
Resumen honesto antes de usar un modelo importado
Con qué datos nació, qué métrica sacó y qué advertencias trae.
Puntuar sin volver a entrenar
Otro día, otro computador, el mismo modelo.
Bilingüe español e inglés
Toda la interfaz, con conmutador de idioma; hay pruebas que fallan si una clave existe en un idioma y no en el otro.
Diccionario de términos
Cada palabra de la app explicada en una línea: baseline, veredicto, fuga, desbalance, importancia, novedad, model card y las cinco métricas.
Los detalles finos
Privacidad
- local only: no
- red saliente: sí
- escribe en las fuentes: no
- usa ia: sí
La app se sirve desde la web y tiene UNA ruta de servidor, así que no es una app local — pero los datos sí lo son: el perfilado, el saneamiento, el entrenamiento y el scoring corren en el navegador con Pyodide, y el dataset nunca se sube a ningún servidor porque no existe uno al que subirlo. La única salida es la narración con IA, y solo cuando el usuario pulsa su botón: viajan nombres de columnas y cifras agregadas —652 B en una medición real—, jamás filas. Los registros técnicos llevan metadatos (número de filas y columnas, tipos), nunca valores.
Stack
- Next.js + TypeScript — la app, en modo estricto y bilingüe desde el primer día
- Pyodide (WebAssembly) — pandas y scikit-learn corriendo dentro del navegador, en un Web Worker, self-hosteados
- scikit-learn — el pipeline anti-fuga, los dos modelos candidatos y los baselines contra los que se juzga
- Vitest y Playwright — las pruebas, incluidas las que fallan si alguien ajusta el preprocesamiento fuera de la mitad de entrenamiento
- Groq — la narración del porqué: opt-in, con guardrails y fallback determinista si falla
- Sentry y Pino — observabilidad de metadatos — nunca contenido del dataset
Cómo se accede
El acceso a la app es por lista de espera, sin promesa de otorgamiento. La producción existe y se muestra en este brochure; el enlace no se publica.
Ningún enlace de acceso viaja en este export: es la regla de cero enlaces del portafolio, no una cuestión de visibilidad del repositorio.
Ficha anclada al export del 2026-08-20 · v0.1.0 · 4 sprints cerrados